Selectie van visualisatie- en analysetools
Wanneer marketingdoelstellingen geformuleerd zijn, personalisatiemogelijkheden zijn gedetecteerd, data is verzameld en de datamaturiteit ervan is gegarandeerd dan kan de volgende fase aangevat worden.
In het voorgaande werd duidelijk dat het creëren van een gezonde datacultuur en het onderhoud van data best wel veel inzet en expertise vragen. Maar eens deze stap werd gezet, zijn je data klaar om geanalyseerd te worden en nieuwe inzichten te genereren. Dit kan in de eerste plaats door gebruik te maken van statistieken en handige visualisaties via dashboards. Deze brengen je zeker al een goed eind op weg om inzichten te bekomen. Maar in een volgende fase kan je beroep doen op artificiële intelligentie. Je kan je data voeden aan de hand van intelligente algoritmes die zelfstandig leren en handelen, de zogenaamde machine learning algoritmen. Deze stellen je in staat om proactief voorspellingen te maken, op zoek te gaan naar segmenten van gelijkgestemden of beslissingsondersteuning te geven. Historische data kan je aanwenden om je klanten beter te leren kennen; via AI kan je als het ware het gedrag van je klant voorspellen en hierop inspelen.
In deze module focussen we o.a. op:
- Enkele visualisatietips
- AI-modellen om te classificeren en clusteren
- Criteria om een tool te selecteren.
5.1 Visualisatie
Datavisualisatie als eerste stap
Onze hersenen blijken heel erg goed te reageren op visuele gegevens en kunnen deze ook verbazingwekkend snel verwerken, sneller dan het interpreteren van tekstuele gegevens. Het is daarom ook niet verwonderlijk dat via een goed gekozen visualisatie een verhaal gebracht kan worden. Op de meeste digitale kanalen neemt visuele content de overhand. Berichten, tweets, artikelen en steeds meer mobiele berichten zijn geheel of gedeeltelijk visueel.
Datavisualisatie kan gedefinieerd worden als zijnde een grafische weergave van zowel informatie als datagegevens die een verhaal vertellen en de nuttige informatie sterk benadrukt. Deze weergave kan in een grafiek, een diagram, tabel of een dashboard voorgesteld worden. Het zorgt ervoor dat trends of patronen meteen opvallen, gezien en begrepen worden. Datavisualisatie vormt dan ook een steeds belangrijker hulpmiddel dat het midden vormt tussen analyse en visuele storytelling.
Visualisatie is dan ook het eerste hulpmiddel dat je kan aanwenden om je data te interpreteren en inzichten te verkrijgen. Misschien is dit al voldoende om je eerste personalisatiestappen te zetten? Je kan snel cijfers in grote datasets vergelijken, verborgen trends in je bedrijfsdata analyseren en begrijpen en op een eenvoudige manier gedetailleerde inzichten overbrengen naar anderen. Bovendien zijn er goede visualisatietools op de markt die je hierin ondersteunen (zie verder).
Hoe kies je het juiste visualisatietype?
In functie van de doelstellingen is het wel belangrijk om de juiste analyse te kunnen maken. En hiertoe is het kiezen van de juiste visualisatie belangrijk. En dit is veel complexer dan je zou denken.
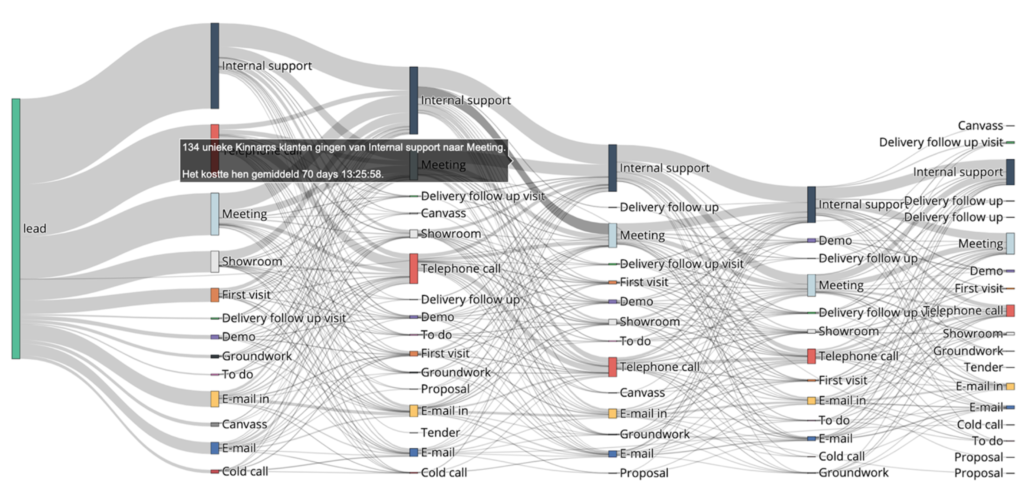
In bovenstaande figuur is het heel moeilijk om het juiste inzicht te verkrijgen enkel door naar de grafiek te kijken. Het idee was om in beeld te brengen welke verschillende contacten en services binnen het bedrijf een lead doorloopt vooraleer over te gaan tot aankoop. Maar enkel door deze visualisatie zijn geen achterliggende verbanden of hypotheses te vinden. Een vuistregel bij het opmaken van een grafiek is dan ook: “less is more”. Het gebruik van kleur, annotaties maar ook het type van de grafiek zelf moet doordacht zijn.
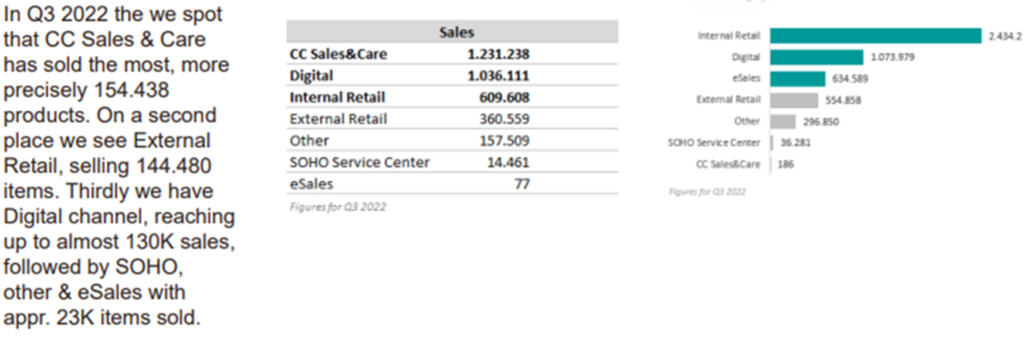
De keuze van het juiste type kan helpen om sneller informatie uit een grafiek te halen. Onderstaande figuur toont dit heel expliciet. De tabel in het midden laat toe om sneller de essentie van de data te vatten dan de tekst links. Maar de bar chart helemaal rechts is in één oogopslag nog duidelijker dan de tabel. De best presterende afdeling staat bovenaan, de horizontale balken duiden niet alleen aan dat ‘Internal Retail’ de best presterende afdeling is, maar je ziet meteen ook de onderliggende verhoudingen tussen de afdelingen, ook doordat de 3 grootste balken in kleur werden weergegeven.
Zo zijn er nog wel enkele pitfalls die we best vermijden als we een keuze maken omtrent het type van een visualisatie. Vaak zie je cirkeldiagrammen opduiken, blijkbaar geven we daar vaak een voorkeur aan. Maar ondertussen is wel vastgesteld dat wij als mens niet goed zijn in het schatten van de grootte van oppervlakken of hoeken, wat wel essentieel is als we cirkeldiagrammen of taartpunten proberen te lezen. We onderschatten hoeken van minder dan 90 graden en overschatten hoeken van meer dan 90 graden. Opnieuw wanneer je het cirkeldiagram in onderstaande figuur vergelijkt met de staafdiagram rechts in de figuur, is het ook hier duidelijk dat deze laatste veel sneller en eenvoudiger te interpreteren is.

Verschillende visualisatietools en visualisatieprojecten (zoals from data to viz) bieden een online beslissingsboom aan, die je door middel van enkele vragen leidt naar een geschikt visualisatietype. Je vindt er ook een mooi overzicht van de meest gemaakte fouten en valkuilen bij het maken van datavisualisaties.
Visualiseren via Business Intelligence Tools, a.k.a. dashboarding
Het visualiseren van je bedrijfsinformatie wordt heel goed ondersteund in de meeste Business Intelligence tools. Ze verwerken, interpreteren en presenteren gegevens uit je bedrijfsprocessen in dashboards en rapporten. De informatie die door BI-software wordt verwerkt, is afkomstig van bronnen zoals spreadsheets, databases, documenten, formulieren, afbeeldingen, bestanden, e-mails, video’s, websitecode en meer. Ze bieden een gebruiksvriendelijke interface voor het verkennen van gegevens, ondersteunen real-time rapportage en stellen gebruikers in staat om gedetailleerde informatie op te vragen.
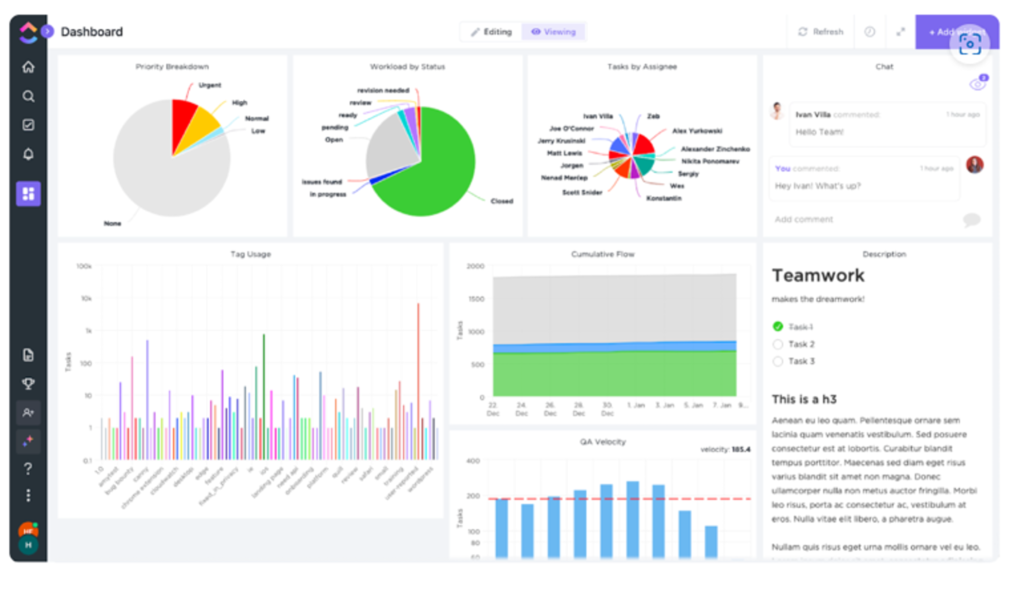
Vooral de dashboards zijn tegenwoordig populair (op het gevaar af van dashboard overloading). Men onderscheidt strategische dashboards die data monitoren en verwerken met oog op een specifiek doel, operationele dashboards die dagdagelijks operaties monitoren voor een bepaalde afdeling en analytische dashboards die specifiek inzichten geven over data in een bepaald tijdsframe.
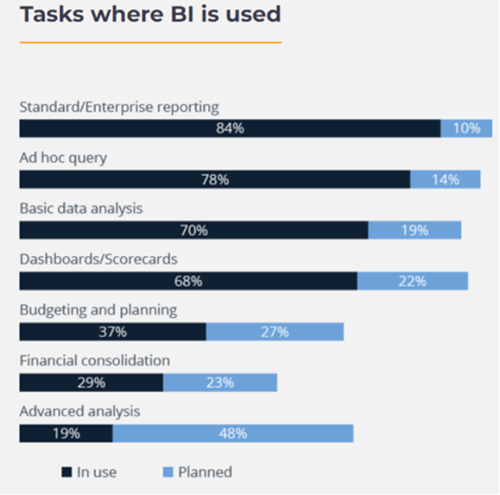
Volgens een recent onderzoek uitgevoerd door BARC (zie figuur XX5) worden deze BI tools voornamelijk gebruikt voor basis rapportering, eenvoudige bevragingen en dashboards. De meer geavanceerde data-analysemogelijkheden van deze tools worden momenteel echter nog niet zo vaak gebruikt, alhoewel 48% van de bevraagden wel aangeeft om het in de toekomst wel te willen gebruiken.
Op basis waarvan kan je beslissen om een BI tool in gebruik te nemen? Er zijn uiteraard veel tools ter beschikking, elk met specifieke mogelijkheden op vlak van integraties met andere producten, dashboarding, aanpasbaarheid, grootte van het bedrijf, rapportering, al dan niet bruikbaar voor beginners en niet-technische personen, … Vertrek vanuit jouw noden en stel vooraf duidelijke vragen op die je kan overlopen met de vendor. Een overzicht van concrete vragen vind je verder.

Naast commerciële tools zijn er uiteraard ook de opensource tools en libraries die je kan aanwenden om zelf met je data aan de slag te gaan. Dit vergt wel de nodige technische achtergrond. Binnen het arsenaal van de data scientist mogen tools als Anaconda, Python notebooks, R en libraries zoals Matplotlib, seaborn, Bokeh en plotnine voor interactieve data manipulatie en visualisatie niet ontbreken.
5.2 Analyse – Model Building
Het analyseren en toepassen van machineleertechnieken op je data is 1 van de specifieke taken binnen het data science process. Deze taak noemt men ook wel model building. De analist of machine learning engineer gaat op zoek naar het gepaste algoritme dat op jouw data losgelaten kan worden om je vooraf bepaalde doel te bereiken.

Een machine leeralgoritme is een stuk software dat taken kan leren. Maar wat betekent dit nu precies? Een definitie ontleent aan T. Mitchell (Machine Learning, McGraw-Hill 1997) stelt dat software leert wanneer deze beter wordt in een bepaalde taak T door ervaring E volgens een gemeten performantiewaarde P. We illustreren dit met een voorbeeld. We neem als taak T het herkennen van een nummerplaat (zoals we ondertussen gewoon zijn wanneer we een parkeergarage binnenrijden). Wanneer kunnen we stellen dat een bepaald stuk software deze taak geleerd heeft? We meten de performantie P van het systeem door te tellen hoeveel nummerplaten uit een set van testnummerplaten perfect herkend worden. De ervaring E is het aantal voorbeelden van nummerplaten die ter beschikking zijn om het stukje software te laten leren. Door heel veel voorbeeldnummerplaten aan het algoritme aan te bieden en telkens ook het aantal foutieve herkenningen te meten die de software maakt in zijn initiële pogingen, kan het algoritme steeds bijgestuurd worden op basis van deze fouten. Wanneer deze bijsturingen ervoor zorgen dat er steeds meer testnummerplaten herkend worden kan je spreken over leren. Het idee is dan ook dat deze trainingen ervoor zorgen dat de software ook in staat zal zijn om nieuwe nog ongeziene nummerplaten te herkennen.
5.2.1 Verschillende vormen van leren: classificatie en voorspellingen maken
Wanneer algoritmen leren op basis van gekende of gelabelde data (men noemt dit vaak ook historische data) zoals de voorbeeldnummerplaten uit het voorbeeld hierboven, spreekt men van gesuperviseerd leren. Je kan dit vergelijken met leren met behulp van een supervisor die aangeeft wanneer je iets juist of fout doet.
Bijvoorbeeld, om foto’s met katten te herkennen heb je heel veel foto’s met katten nodig die gelabeld zijn als zijnde positief: ‘een foto met een kat’ en heel veel andere foto’s zonder katten die gelabeld zijn als negatief: ‘een foto zonder kat’. Deze gelabelde data is de data waarop getraind en getest kan worden. Deze moet kwalitatief zijn en juist gelabeld zijn, anders zal het algoritme geen correcte categorisatie of voorspellingen doen. Het correct labelen van de data is dan ook zeer belangrijk en een intensief proces, waarbij ruwe gegevens (afbeeldingen, tekstbestanden, video’s, enz.) betekenisvolle en informatieve labels krijgen om context te bieden aan het leren. Gesuperviseerde leeralgoritmen werken op basis van deze labels; ze lossen een classificatieprobleem op. Ze kunnen gebruikt worden om voorspellingen te doen: zal deze klant bijvoorbeeld overgaan tot een specifieke aankoop of zal deze klant afhaken? Je voorspelt een categorie op basis van een eindig aantal vooropgestelde mogelijkheden, zoals in het voorbeeld van een spamfilter, die mails classificeert als zijnde “spam of geen-spam”.
Een andere vorm van gesuperviseerd leren is regressie. Bij regressie wordt geen categorie, maar een waarde voorspeld: bijvoorbeeld “wat is de vermoedelijke verkoopprijs van dit huis met zijn specifieke kenmerken in een specifieke regio?”. Misschien is er wel een historische databank voorhanden met een volledige beschrijving van verkochte huizen en hun uiteindelijke verkoopprijs. Deze data kan dan dienen om het algoritme te trainen en testen, zodat deze na het leren kan gebruikt worden om de prijs van nieuwe huizen te voorspellen.
Labels en features
Zowel bij classificatie als regressie moeten heel veel gelabelde trainingsdata beschikbaar zijn. Voldoende gelabelde data ter beschikking hebben is niet altijd eenvoudig. Deze gegevens manueel toevoegen aan je data kan heel wat extra werk betekenen. Datalabeling is echter wel noodzakelijk om de kwaliteit van het leren te verhogen. Je kan tegenwoordig beroep doen op gespecialiseerde service providers of crowdsource platformen om je te laten helpen om je data te labelen. Niet alles hoeft manueel gelabeld te worden, er bestaan ook automatische en semi-automatische technieken waarbij een hybride aanpak van human-in-the-loop (HTIL) populair zijn.
Soms helpen we als crowd onbewust mee aan het labelen van datavoorbeelden, denk maar aan de vragen die je soms moet beantwoorden vooraleer je een online formulier kan doorsturen. reCAPTCHA is een handig systeem om software bots te herkennen op je pagina, maar anderzijds door aan te duiden welke beelden huisnummers, verkeerslichten en moeilijk leesbare woorden bevatten help je mee om data te annoteren zodat deze gebruikt kan worden voor het trainen van nieuwe leermodellen.
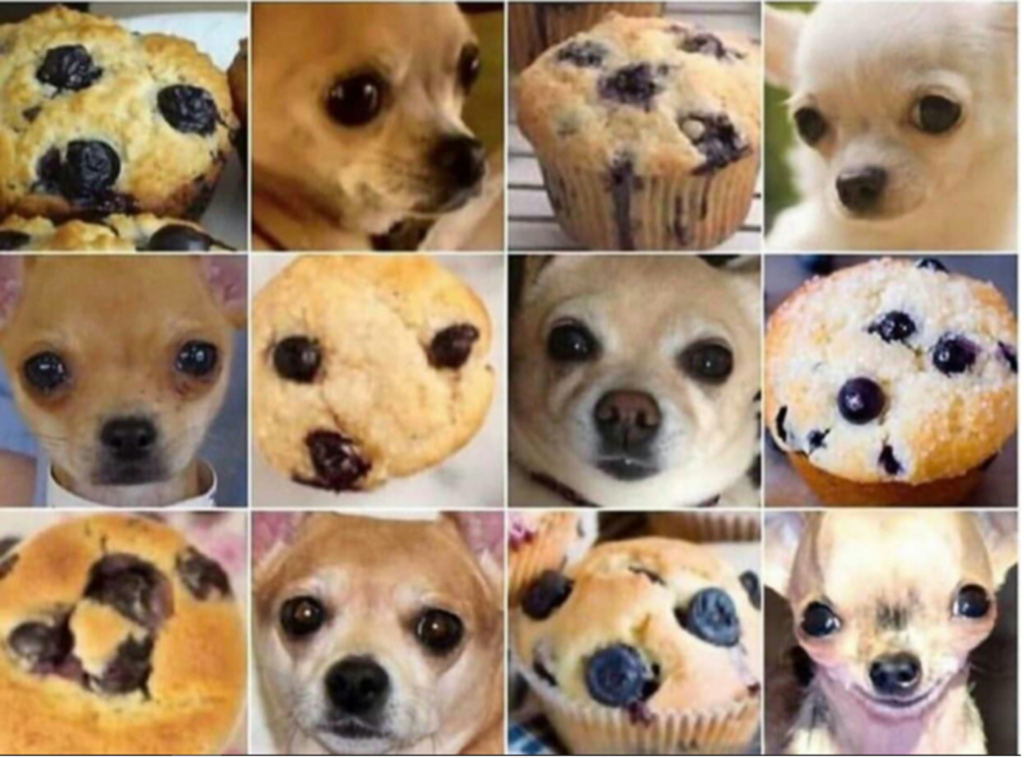
Ondanks een goed gelabelde dataset kan het voorspellen van een categorie een moeilijke taak blijken, dit wordt mooi geïllustreerd in het voorbeeld van onderstaande figuur.
Niet alleen moet data gelabeld zijn, data moet ook beschreven worden aan de hand van kenmerken of de zogenaamde features. In het geval van een foto kan je elke pixel in de foto beschouwen als een kenmerk van de foto. Wanneer je voorspellingen wil doen over klantenaankopen dan zijn je klanten je data en kan je deze beschrijven aan de hand van typische persoonsgebonden kenmerken zoals: leeftijd, woonplaats, accountgegevens maar ook gedragskenmerken als: laatste aankoop, hoeveel gespendeerd, laatste websitebezoek, welke downloads gedaan, maar ook contentgebaseerde kenmerken als: interesse in welke producten of artikels, reageert op welke nieuwsbriefitems, welke post geliket enz. Sommige van deze kenmerken gaan heel relevant zijn voor de voorspelling andere minder. Een goed algoritme zal automatische de meest relevante kenmerken gaan gebruiken om een hypothese op te stellen die gebruikt zal worden om de voorspelling te maken. Welke hypothese het algoritme uiteindelijk gevonden heeft om beslissingen te nemen is echter niet altijd duidelijk. Bij de klassiekere machine leeralgoritmen kan dit nog enigszins afgeleid worden. Bijvoorbeeld een beslissingsboom algoritme stelt een set van regels op om beslissingen te nemen, welke kenmerken hierbij gebruikt worden kan je achterhalen. Modernere deep-learning neurale netwerken zijn echter volledig black box, je hebt geen idee op basis van welke kenmerken van je data ze werken. Zo zijn er voorbeelden van AI-algoritmen die classificeren op verkeerde informatie. Gekend is het voorbeeld van de classificatie van wolven versus huskys. Het merendeel van de foto’s met wolven was getrokken in een sneeuwlandschap. Wolven werden dan ook alleen herkend op basis van het al dan niet terugvinden van sneeuw in de foto.
Een ander aandachtspunt is wanneer het algoritme de trainingsdata gaat overfitten. De geleerde hypothese zal de trainingsdata zo perfect gaan fitten dat de hypothese of voorspeller niet bruikbaar is voor nieuwe situaties, ze is namelijk niet algemeen genoeg meer.
5.2.2 Verschillende vormen van leren: clusteren en aanbevelingen doen
Naast het maken van voorspellingen zijn de aanbevelingssystemen (recommandation engines) een populaire toepassing van klassieke machine leeralgoritmen. Deze systemen zijn voorbeelden van niet-gesuperviseerd leren. Er is geen supervisor of gelabelde data aanwezig op basis waarvan men software kan trainen en testen. De data waarvan men vertrekt is de pure input, i.e. de beschrijvende features of kenmerken. Een typisch voorbeeld van niet-gesuperviseerd leren is clustering. Data clustering is de taak waarbij data wordt onderverdeeld in verschillende groepen. Datapunten die door het algoritme in dezelfde cluster belanden moeten over voldoende overeenkomsten beschikken. Omgekeerd moeten datapunten uit verschillende clusters uiteenlopende eigenschappen bezitten.

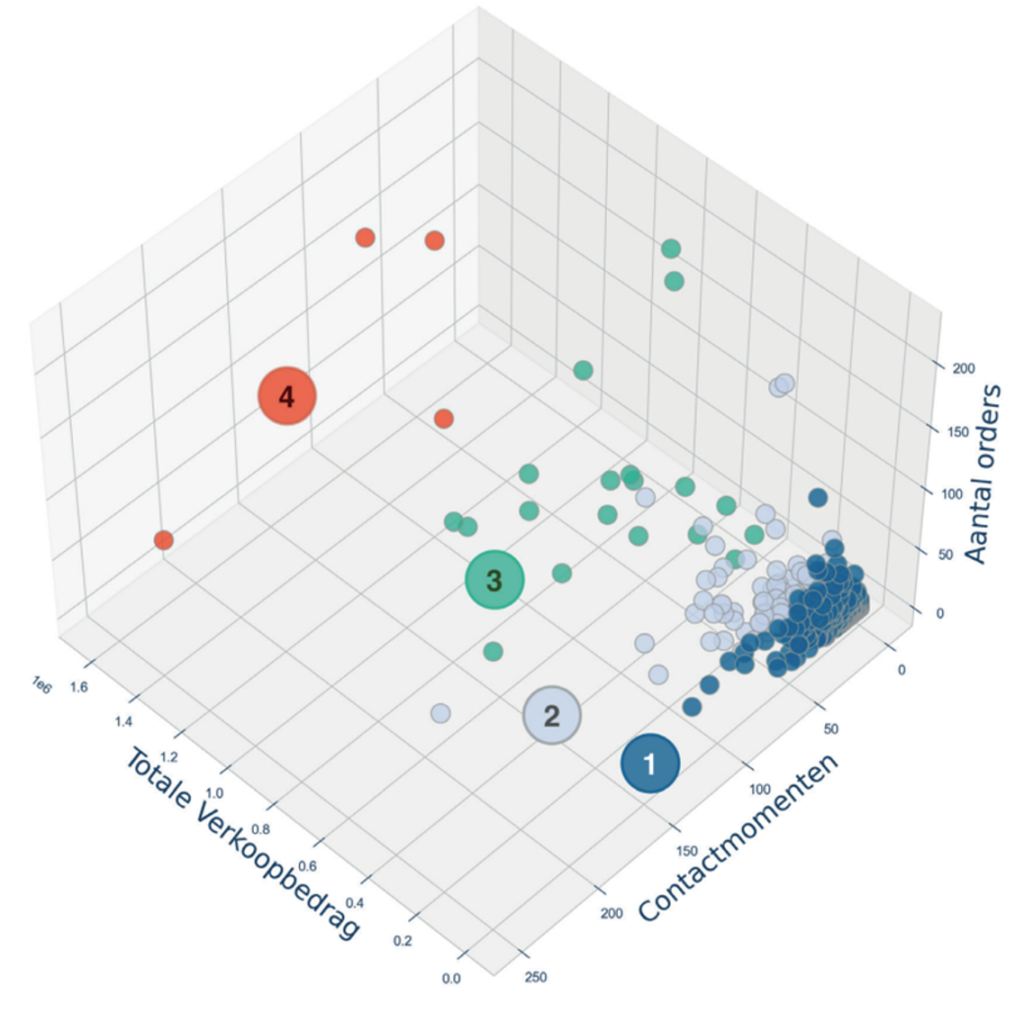
Clustering kan er op een automatische manier voor zorgen dat al je klanten in groepen onderverdeeld worden op basis van hun profielen. Je ziet dan bijvoorbeeld dat het vooral mensen van boven de 40 uit een bepaalde regio zijn die bij jou producten van meer dan 50 euro kopen. Deze groepen kan je dan afzonderlijk en persoonlijk gaan benaderen. In meerdere cases van het start2AIM project werd clustering toegepast als eerste voorzichtige toepassing van AI. In de Odisee-case (FiguurXX8 + link naar case) werden terugkerende websitebezoekers automatisch in een cluster gestopt volgens de interesse die ze vertoonde tijdens het browsen. Op basis hiervan kunnen deze websitebezoekers een licht aangepaste versie van de website te zien krijgen bij een volgend bezoek, de voor hen interessante informatie is meteen zichtbaar gemaakt. In de Kinnarps case (Figuur XX9 + link naar case) werden klanten automatisch geclusterd volgens hun aankoopprofiel.
Dit is ook de basis van de aanbevelingssystemen of recommandation engines. Klanten die een aankoop doen of overwegen krijgen suggesties die in de lijn liggen van wat ze aankochten of wat hen interesseert. Denk maar aan de suggesties die je bij Amazon (de king of recommendations genoemd) krijgt als je een artikel selecteert: “vaak samen gekocht met deze andere artikelen” of nog “klanten die dit item kochten kochten ook …”. Grote spelers investeren veel tijd en energie in het verbeteren van hun recommandation engine. Zo ook Netflix, die zijn kijkers zo lang mogelijk wil binden door nieuwe series en/of films te suggereren. Netflix Investeert in het herkennen en creëren van rond de 2000 clusters of groepen met vergelijkbare interesses. Op deze manier kan het zijn recommandation engine heel effectief maken bij het suggereren van nieuwe content aan de kijker. Slechts 40 tot 50 titels die in de kijker zijn persoonlijke interessegebied liggen worden getoond op de gebruiker zijn homepage, waardoor deze niet overweldigd wordt en op het platform blijft. Bovendien geeft het ook inzicht in welke series ze zelf moeten maken.

Recommandation engines zijn meestal gebaseerd op collaborative filtering en/of content-based filtering. Deze laatste doet zijn suggestie door producten te vergelijken en gelijkaardige producten aan te bieden als suggestie. Collabarative filtering zal eerder gebruikers gaan vergelijken en content die gebruikers uit jouw cluster preferen, suggereren aan jou. Maar hoe kan je gebruikers, en producten als boeken en films op een automatische manier vergelijken? Ook hier worden de features van de data gebruikt. Een boek of klant zal getransformeerd worden naar een wiskundige vector in een meerdimensionele vectorruimte. Elk feature of kenmerk zal 1 dimensie worden uit die ruimte. Op die manier kunnen echte wiskundige afstanden berekend worden tussen boeken of klanten of films.
5.3 Tools voor personalisatiedoeleinden
Een gigantisch aanbod van digitale tools zijn ter beschikking binnen het segment van marketing technologie. In 2023 was er sprake van meer dan 11.000 tools en men verwacht nog een aanzienlijke stijging in 2024 door de in gebruik name van generatieve AI. Voor de marketeer vormt de keuze van een tool dan ook een groot probleem. Vaak wordt een kwart van hun budget besteedt aan tools die nauwelijks worden gebruikt en vaak overlappende functies hebben, terwijl ze constant worden gebombardeerd met nieuwe technologie.
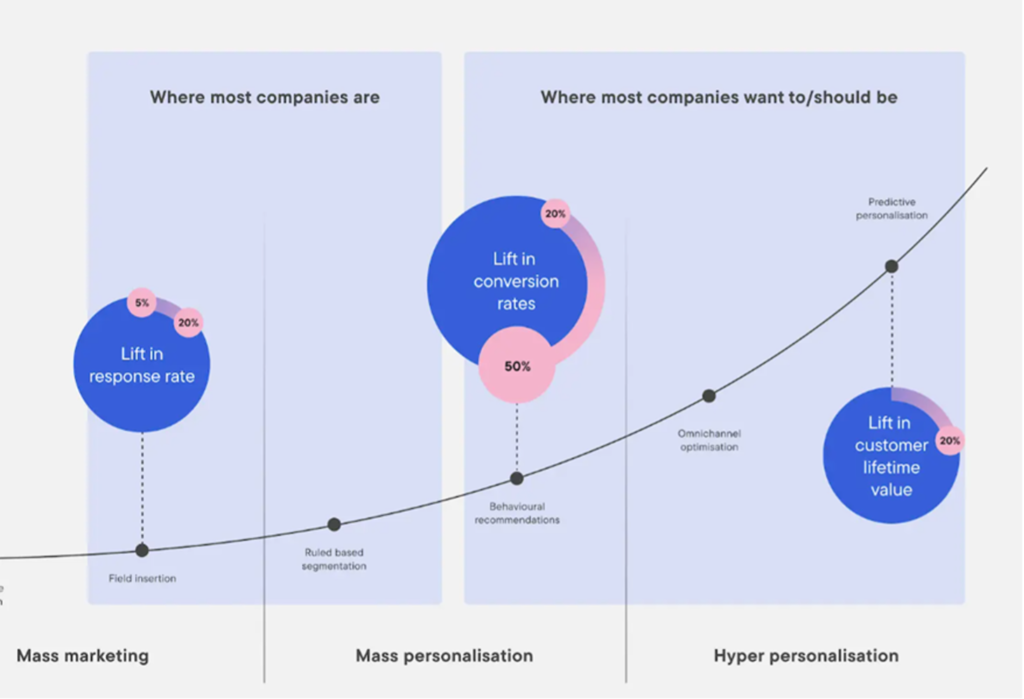
En dit terwijl een tool nooit een antwoord op zich is. Voor wat personalisatie betreft is het belangrijk om te weten waar op de personalisatiecurve je je bevindt (figuurXX12). Pas wanneer je je in de fase van de hyper-personalisatie bevindt kan je een customer data platform (CDP) en of datamanagement platform (DMP) ten volle gebruiken om een 360 graden beeld van je klant op te bouwen en deze persoonlijk aan te spreken.
Gemiddeld blijkt klantdata verdeeld te zijn over 5 losse systemen die hoogstwaarschijnlijk nooit bedoeld waren om te integreren. Klantdata is evenwel alleen bruikbaar als de data niet langer verzuild is, maar geïntegreerd en toegankelijk. Een Customer Data Platform (CDP) komt hieraan tegemoet en verzamelt klantdata uit meerdere databronnen — zoals website, advertentiekanalen, CRM en meer — om hier één robuust klantprofiel van te maken. Een CDP gaat klanten uniek identificeren en biedt hierdoor een “holistisch” weergave van de klant, gebaseerd op data uit elk stadium van het traject van die klant, hierbij wordt steeds de integriteit en de controle van data gerespecteerd. Een CDP vereist wel dat de organisatie matuur genoeg is op vlak van data en technologie.
Marketingtools zijn ondertussen ook geëvolueerd naar “Marketing Cloud oplossingen”. Je betaalt typisch voor de service die je vraagt en eventueel ook de opslag van de data – “pay for what you use” en “pay as you grow”. Techreuzen kunnen investeren in eigen gebouwde ML modellen maar de zogenaamde Machine Learning as a service (MLaaS) biedt nu ook kleinere spelers de toegang tot het trainen en deployen van ML modellen voor toepassingen als gezichtsherkenning, beeldherkenning, voorspellingen, natural language processing ed. Dit maakt dat deze kennis nu toegankelijk wordt, gemakkelijk aanspreekbaar via grafische interfaces en met vaak al vooraf getrainde modellen die gebruikt kunnen worden.
Verschillende van onderstaande criteria bij de keuze van een tool kunnen van belang zijn voor je bedrijf. Je kan ze vooraf met de vendor overlopen om nadien niet voor verassingen te komen staan:
- toekomstbestendigheid en schaalbaarheid: is dit een oplossing die kan meegroeien met de ambities die je hebt? Zo ja, hoe eenvoudig is het om eventuele extra modules of uitbreidingen in gebruik te nemen?
- functionaliteit: is de tooling compleet in de functionaliteiten die het aanbiedt, en kan je het daardoor met minder verschillende tools?
- flexibiliteit: is het product volledig naar wens en behoefte in te richten, of biedt het een one-size-fits-all oplossing?
- onderhoud: in hoeverre dient de oplossing na de implementatie nog onderhouden en geüpdate te worden? Heb je hierbij externen nodig en wat is de kostprijs hiervan?
- vereiste vaardigheden van het team: is de tooling voor iedereen te gebruiken, of is er specialistische kennis vereist? Is de leercurve hoog? Wat is de investering die nodig is opdat deze in gebruik genomen kan worden?
- veiligheid en privacy: is de tool veilig en gaat het conform de geldende wetgeving (AVG / GDPR) om met persoonsgegevens?
- minimum aantal bezoekers: Er valt pas echt iets te personaliseren wanneer je website een minimaal aantal bezoekers per dag trekt. Met te weinig bezoekers verzamel je te weinig kwalitatieve data om je strategie te optimaliseren.
Voor de meeste organisaties is een volledig op machine learning gebaseerd systeem in gebruik nemen om je personalisatie strategie te optimaliseren nog een grote stap. Beschikken over een multifunctioneel team is een must om met een AI-traject aan de slag te gaan. Data analisten, (digital) marketeers, designers en developers, verschillende competenties zijn noodzakelijk. Er moet kennis zijn van:
- de business
- marketing
- data en statistiek
- machine learning
- IT systemen
Niet ieder bedrijf heeft al deze profielen in dienst, en daarom is het goed om de juiste specialisten aan te nemen of deze werkzaamheden uit te besteden.
Het omgaan met deze uitdagingen vereist niet alleen juridische en technische expertise, maar ook een diepgaand begrip van de ethische en maatschappelijke aspecten van AI. Ondernemers moeten zich voortdurend bewust zijn van de evoluerende landschappen van regelgeving, cybersecurity en gegevensprivacy om verantwoordelijk en succesvol gebruik van AI te garanderen.