Laat je inspireren door enkele Vlaamse personalisatiecases
Gepersonaliseerde benadering door sales consultants dankzij klantendata.
Eén van de sterktes van de sales consultant is zijn buikgevoel, maar is dit altijd de beste keuze? Aan de hand van de klantendata verifiëren we dit en sturen we bij tot een meer gepersonaliseerde benadering.
Kinnarps is een Zweeds bedrijf in interieuroplossingen dat actief is in meer dan 40 landen. Het bedrijf biedt naast innovatief, ergonomisch, duurzaam en aantrekkelijk kantoormeubilair ook totaaloplossingen aan voor het creatief, hedendaags kantoor. Voor alle soorten werkplekken voorziet Kinnarps een doordacht ontwerp van hoge kwaliteit met een beperkte impact op het milieu.
De focus van Kinnarps ligt vooral op projectverkoop (eerder dan productverkoop) en dit in een B2B-context. Er wordt dus niet actief ingezet op particuliere verkoop, al heeft men als particulier wel de mogelijkheid om in de showroom een bestelling te plaatsen. Het bedrijf is in België (hoofdzakelijk in Vlaanderen) vooral succesvol in het ‘Kantoor’-segment, maar wil ook meer gaan inzetten op de segmenten ‘Zorg’ en ‘Opleiding’. In het kader van deze samenwerking hoopt Kinnarps meer kennis te verwerven over de mogelijkheden die extra data bieden. Vervolgens wil het meer gerichte marketingacties opzetten op basis van datagedreven segmentering.
Deze use-case werd aangebracht door Geert Vromman van Cropland en uitgevoerd door het Start2AIM-onderzoeksteam.

www.kinnarps.be
Katrijn.Vekens@kinnarps.be

Belangrijkste learning
- Het consistent bijhouden van gestructureerde klantendata (sector, aantal medewerkers, omzet) reeds bij aanvang van de customer journey is cruciaal om aan data-gedreven marketing te doen.
- Een nauwe samenwerking en terugkoppeling tussen marketing, sales en IT afdeling is vereist om een datacultuur op lange termijn te onderhouden/behouden. Personeel moet gemotiveerd worden om ook data consistent bij te houden waarvan het potentieel pas kan worden verkregen op lange termijn.
Personalisatie use-case
De belangrijkste doelstelling van Kinnarps is de omzet verhogen door enerzijds nieuwe klanten in segmenten zoals ‘Opleiding’ en ‘Zorg’ aan te trekken en anderzijds de klantbeleving en trouw van bestaande klanten te verbeteren om zo de Customer Lifetime Value te verhogen.
Er wordt vandaag een zeer beperkte gepersonaliseerde aanpak gehanteerd op basis van de beschikbare klantendata. Sporadisch worden klanten aangesproken op basis van hun koopgedrag, al zijn dergelijke beslissingen nu vooral gebaseerd op het buikgevoel. Aan de basis van deze beperkte gepersonaliseerde aanpak ligt een drempel bij de sales consultants voor het bijhouden van data omdat ze niet altijd de meerwaarde zien van hun administratieve inspanning. Een uitdaging naar de toekomst toe, is te verduidelijken hoe dit toch een positief effect kan hebben op de verkoop en het verkoopproces.
Kinnarps wil in de toekomst dus graag hun beslissingen onderbouwd zien, eventueel met behulp van AI. Anno 2021 zijn enkele voorbeelden van pijnpunten het niet consequent en correct verzamelen van data, die vervolgens op een niet-uniforme manier bijgehouden worden in het CRM- en ERP-systeem. Het bedrijf wil de mogelijkheden bekijken van personalisatie op vlak van content, context en campaign targeting.
Op basis van de beschikbare data, en rekening houdend met de marketingdoelstellingen, werd gekozen om allereerst de huidige klantindeling onder de loep te nemen. Momenteel krijgen de klanten van Kinnarps een klantenpotentieel code (A, B, C of D) toegewezen door de salesverantwoordelijken. Deze code geeft de grootteorde aan van de klant, zijn (potentiële) projecten, en de daaruit verwachte omzet. Om deze code te bepalen, worden klantgegevens als jaaromzet en aantal werknemers mee in rekening genomen, al is deze informatie in vele gevallen niet aanwezig, waardoor de toewijzing vooral een subjectief karakter heeft.
Er werd getracht om aan de hand van AI patronen te detecteren binnen het klantenbestand. Op deze manier kan men klanten in de toekomst persoonlijker, gerichter en actiever aanspreken. De eigen klantenverdeling kan uiteindelijk bijgestuurd worden.
Strategische aanpak
Samen met de marketingverantwoordelijke van Kinnarps werden de doelstellingen en datacultuur in kaart gebracht, een essentiële stap die voorafgaat aan de technische uitwerking van de case.
Op het vlak van bedrijfs- en marketingdoelstellingen is het duidelijk dat Kinnarps de hoogste prioriteit geeft aan het verhogen van de omzet door nieuwe klanten aan te trekken enerzijds, en het verhogen van de klantbeleving anderzijds. Andere aspecten, zoals klantgetrouwheid en de customer lifetime value verhogen, worden evenmin uit het oog verloren. Kinnarps wil hierbij ook meer data inzetten om beslissingen (beter) te onderbouwen.
Wat betreft bedrijfs- en datacultuur/-expertise, blijkt dat het urgentiebesef over het gebruik en het juist inzetten van data, sterk aanwezig is. Aangezien er geen interne expertise aanwezig is, worden zaken betreffende innovatie en digitale transformatie uitbesteed aan externe partners. Intern is er nog geen echte datacultuur aanwezig: er is nood aan het beter structureren en het consequent bijhouden van data. Bijgevolg zijn de data momenteel niet (rechtstreeks) bruikbaar voor analysedoeleinden en wordt het volledige potentieel van de data niet benut.
Ook de datamaturiteit – zoals het verzamelen en bewaren van data, evenals de kwaliteit van de aanwezige data – werd in kaart gebracht. Hieruit blijkt dat de data op een actieve manier worden verzameld door salesverantwoordelijken die rechtstreeks vragen aan de klant stellen (zowel online als offline). De data worden hoofdzakelijk opgeslagen in het CRM- en ERP-systeem van Kinnarps.
De integratie tussen deze systemen onderling is beperkt, wat maakt dat het opstellen van analyses op basis van samengevoegde data een uitdagende taak is en enige technische kennis vereist. Hiervoor wordt dan ook samengewerkt met technologische (externe) partners. Uit deze data kunnen momenteel enkele bruikbare en relevante inzichten verworven worden door onder andere de opvolging na verkoop of dienst-na-verkoop. Verder is ook op te merken dat een groot deel van de velden optioneel in te vullen is, wat maakt dat de data niet volledig zijn en het maken van analyses bemoeilijkt wordt.
Op dit moment wordt er geen gebruik gemaakt van Machine Learning-modellen en worden voornamelijk inzichten verworven op basis van geaggregeerde data, zoals Google Analytics-rapporten. Na zes maanden zonder klantactiviteit wordt de prospect uit het CRM-systeem verwijderd.
Aan de slag met de data
Het inzetten van data waaruit patronen gedetecteerd kunnen worden, of voorspellingen omtrent aankopen gemaakt kunnen worden, of het inzetten van personalisatie om de juiste producten voor te stellen, staan centraal in het proces om bovenvermelde doelstellingen te behalen.
Op basis van klant- en bestelinformatie worden door middel van een clusteringsalgoritme gelijkaardige klanten automatisch gegroepeerd. De klantindeling die op die manier wordt verkregen, wordt vervolgens afgetoetst aan de door Kinnarps gemaakte klantindeling (klantenpotentieel code).
De gebruikte data zijn verspreid over verschillende systemen en dienen eerst samengevoegd te worden. Zinvolle eigenschappen of features worden vervolgens gedetecteerd. Op basis hiervan kunnen klanten ingedeeld worden.
Volgende data zijn aanwezig:
- Bestelgegevens (ERP)
- Aangekochte producten
- Bestelbedrag
- Aankoopdatum
- Klantinformatie (CRM)
- Het aantal en type geregistreerde contactmomenten
Voor deze verwerking werden bepaalde tools ingezet. Voor de uitwerking van dit scenario werd gebruik gemaakt van een gratis open-source machine learning-bibliotheek (Scikit-Learn, 2021c) die kan gebruikt worden wanneer men ontwikkelt in de Python-programmeertaal. Python is een van de meest gebruikte programmeertalen en erg geschikt voor data-analyse en machine learning.
De combinatie van Python en Scikit-learn geeft de ontwikkelaar veel flexibiliteit, al is er een aanzienlijke technische kennis vereist om hier zelf mee aan de slag te gaan. Customer segmentation zit vaak ook ingebouwd in marketing-tools en CRM-systemen, waardoor KMO’s hiermee op een laagdrempelige manier mee aan de slag kunnen gaan.
Welke resultaten kan men nu verwachten? K-Means (Scikit-Learn, 2021a) is een clusteringsalgoritme uit de Scikit-learn bibliotheek dat toelaat gelijkaardige klanten te groeperen op basis van hun eigenschappen. Als input verwacht het algoritme de eigenschappen waarop de clustering moet gebeuren en het aantal clusters dat men wil bekomen.
Klantinformatie, zoals het aantal werknemers en de gerealiseerde omzet, wordt door Kinnarps helaas niet consistent bijgehouden.
Alternatief worden volgende eigenschappen gebruikt om aan segmentatie te doen:
- Totale aankoopbedrag
- Aantal contactmomenten
- Aantal bestellingen
Het clusteringsalgoritme verdeelt de klanten op basis van hun eigenschappen automatisch in clusters opdat klanten binnen elke cluster zo dicht mogelijk bij elkaar en tegelijkertijd zo ver mogelijk van klanten in andere clusters zijn verwijderd. Elke cluster wordt gekenmerkt door zijn middelpunt, wat het gemiddelde van de gebruikte eigenschappen voorstelt binnen de cluster.
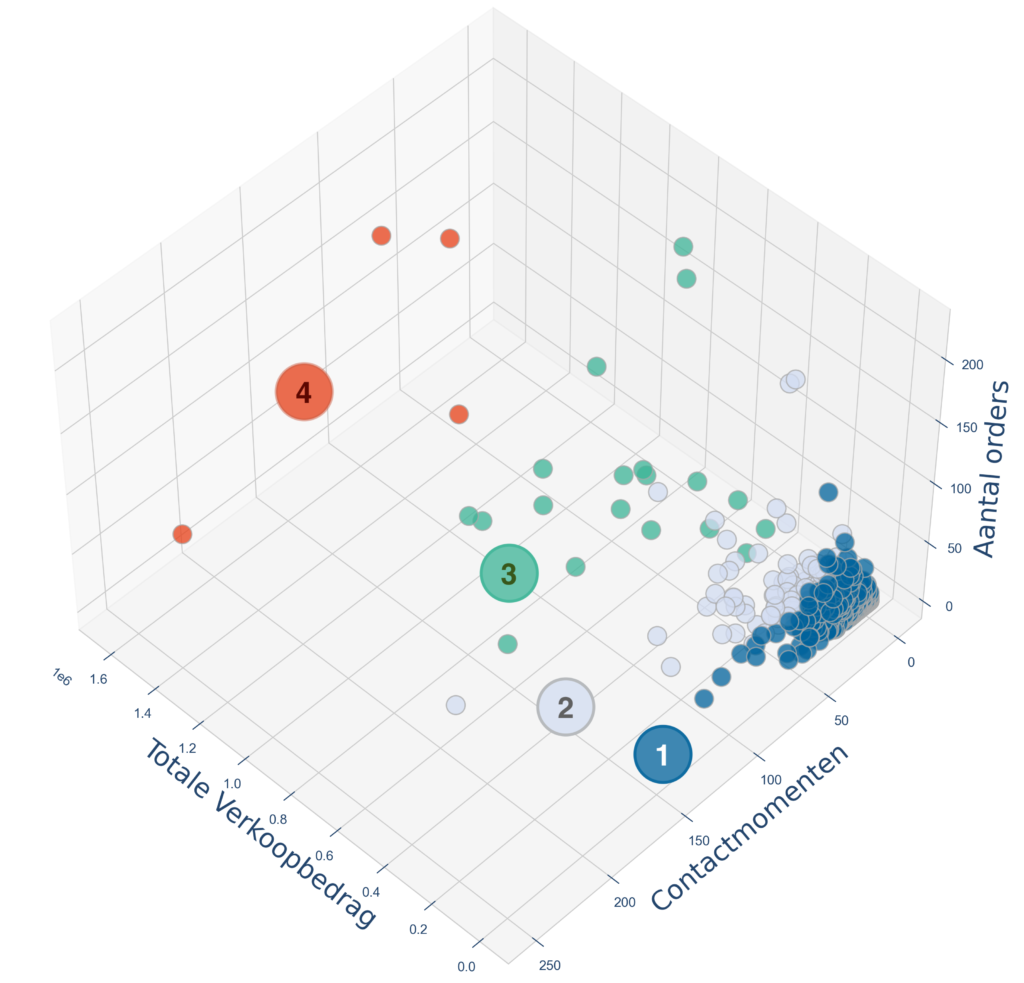
Gebruik makende van klantdata over een periode van 4 jaar, laten we het algoritme 4 clusters genereren. De gerapporteerde waarden in de tabel stellen de gemiddelden voor die samen het middelpunt van een cluster voorstellen.
Cluster | Gemiddeld totale aankoopbedrag | Gemiddeld aantal contactmomenten | Gemiddeld aantal bestellingen | Aantal klanten binnen de cluster |
1 | 10283 | 8 | 4 | 1662 |
2 | 147345 | 33 | 24 | 107 |
3 | 605008 | 72 | 83 | 19 |
4 | 1376600 | 125 | 132 | 4 |
De klanten en de clusters waartoe ze behoren kunnen ook gevisualiseerd worden in een 3D-plot. Elke cirkel stelt hierbij een klant voor, waarbij de kleur aangeeft tot welke cluster zij/hij behoort.
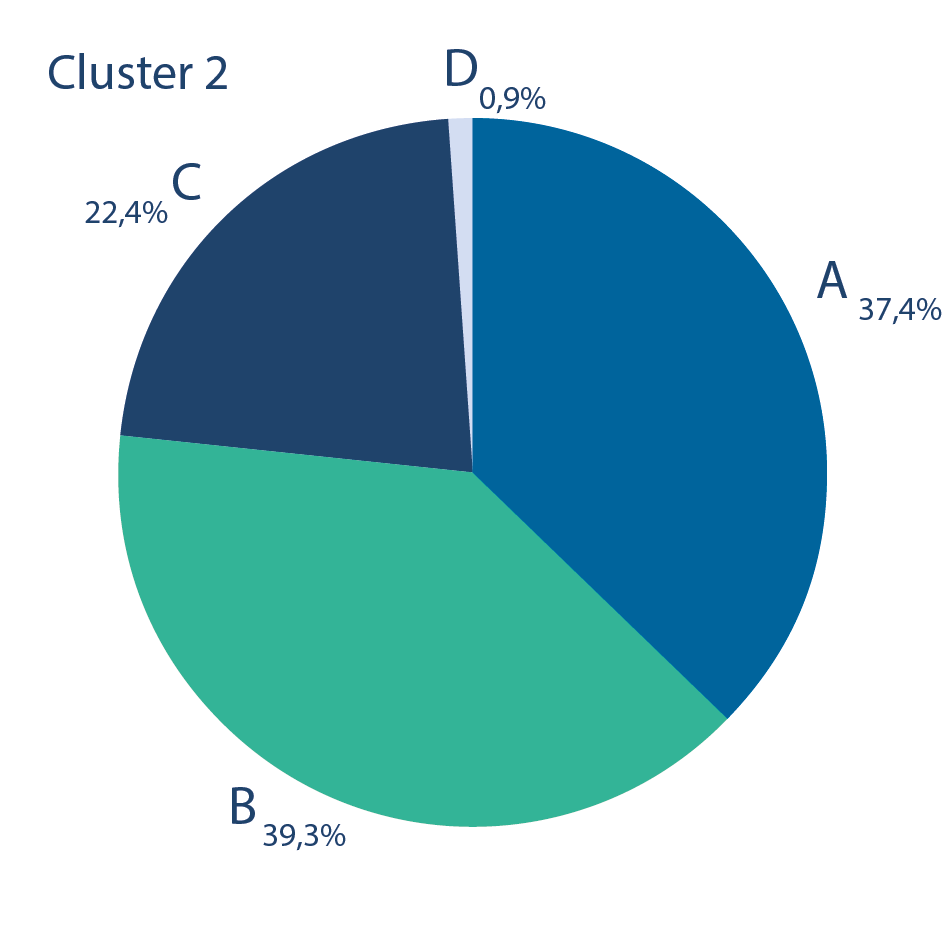
Vervolgens wordt de huidige onderverdeling van Kinnarps gestaafd aan de resultaten uit de clustering. Volgende diagrammen geven de verdeling van de oorspronkelijke klantenpotentieel code (A/B/C/D) weer binnen elke cluster.


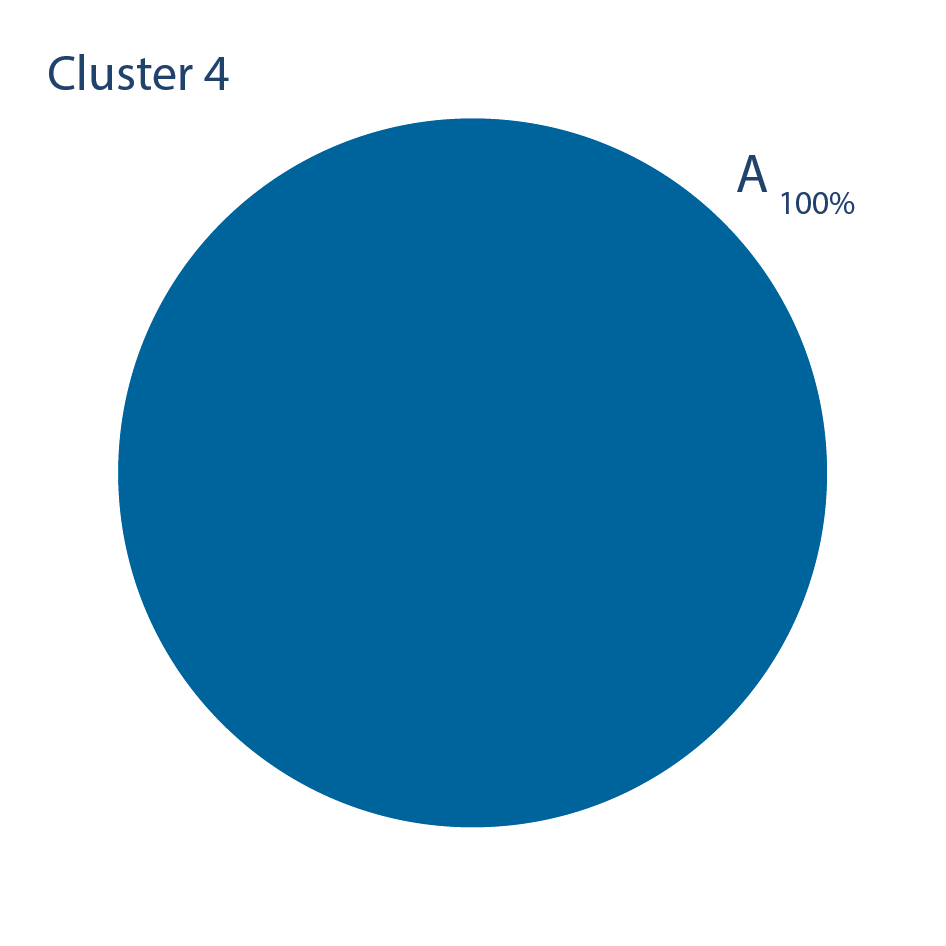
Bij het analyseren van bovenstaande resultaten is duidelijk dat in clusters 3 en 4 – die een hoog aankoopbedrag, aantal contactmomenten en orders voorstellen – bijna uitsluitend grote klanten aanwezig zijn.
Opmerkelijk is dat in cluster 1, die de klanten voorstelt met het laagste aankoopbedrag, aantal orders en contactmomenten, het aandeel van de kleine klanten (C en D) het grootste is, al zijn er ook een aanzienlijk aantal A- en B-klanten terug te vinden.
In cluster 2, die de middelgrote klanten representeert, is het aandeel van A- en B-klanten toegenomen, al zijn er nog wel enkele particulieren terug te vinden (D-klanten).
Conclusies
De door het algoritme gegenereerde clusters tonen gelijkenissen met de huidige onderverdeling op basis van de klantpotentieelcode. Toch lijkt de huidige klantenpotentieel code te algemeen om op basis hiervan de klanten gepersonaliseerd aan te spreken. Zo zijn er een aanzienlijk aantal klanten die door het algoritme als middelgroot worden geclassificeerd (cluster 2) en die toch door Kinnarps als particulier worden beschouwd (klantpotentieelcode D). Aangezien particulieren geen prioriteit zijn binnen de huidige marketingstrategie, bestaat het risico dat deze klanten niet op de juiste manier worden getarget.
Wanneer ook data bijgehouden worden met betrekking tot de identiteit van de klant (omzet, aantal medewerkers, sector, omvang bedrijf, Decision Making Unit), kan men klanten in het begin van de customer journey indelen en op die manier gepersonaliseerd aanspreken. In dit specifieke voorbeeld zou men een beter onderscheid kunnen bekomen tussen Cluster 1 en 2.
Waar de rol van AI in de eerste fase beperkt blijft, kan men in een later stadium technieken aanwenden om op een geautomatiseerde manier aan marketing te doen.
Er blijft met andere woorden nog een aantal uitdagingen bestaan. Het is duidelijk dat data een belangrijke rol spelen om de marketingdoelstellingen te volbrengen. Het opzetten en onderhouden van een datacultuur houdt in dat data consistent en gestructureerd worden verzameld en opgekuist.
In het specifieke geval van Kinnarps staan salesverantwoordelijken in om data op een correcte manier in te geven. Om op een data-gedreven manier aan marketing te doen is het enerzijds nodig dat men dit afdwingt op data-niveau door enkel gestructureerde en verplichte gegevens te laten invullen in het CRM- en ERP-systeem. Verder is het vereist om het nut van databeheer resultaatgericht aan te tonen en op die manier salesverantwoordelijken te motiveren op langere termijn.
In een vervolgstap kan AI ingezet worden om aan marketing automation te doen en op die manier klanten proactief te benaderen en tegelijk manuele taken van salesverantwoordelijken te verlichten. Dit kan door:
- Extra profielinformatie bij te houden (sector, aantal medewerkers, DMU)
- Klanten sneller en makkelijker door customer journey te loodsen (vanaf de start bijhouden wie er binnenkomt en op welke manier)
- Effort te relateren aan slaagkansen
Hoe een reisorganisatie zijn klanten beter leerde kennen.
Gek van paardrijden én op reis gaan? TrailFinders maakt dit mogelijk door het aanbieden van paardrijvakanties overal ter wereld. Het afstemmen van marketingacties op hun gevarieerde doelgroep start met het exploreren van hun jarenlang verzamelde data.
TrailFinders is een reisorganisatie die ruim 30 jaar ruitervakanties aanbiedt over de hele wereld, met voornamelijk klanten in België en Nederland. Het gaat daarbij vooral om paardrijvakanties en ponykampen. De aangeboden vakanties omvatten de vlucht, de accommodatie, en eventuele gekozen verzekeringen.
Klanten kunnen via de website van TrailFinders bestemmingen raadplegen die voldoen aan hun vereisten en vervolgens via een online formulier hun boeking voltooien. Vanaf dat moment worden alle acties en communicatie met de klant bijgehouden in een door een externe partner aangeleverd boekingssysteem.
TrailFinders wil zich in de eerste plaats profileren als betrouwbare organisatie die klanten op een zorgeloze manier van een leuke reiservaring kan laten genieten. Hierbij wil men de klant ontlasten door alle administratieve zaken voor hen reeds af te handelen. Om hun doel te verwezenlijken is het een vereiste om klanten op een persoonlijke en gerichte manier te benaderen.
De focus van TrailFinders ligt dan ook op het beter leren kennen van hun klanten. Door het analyseren van de bestaande data, kan men hier een beter zicht op krijgen. Op basis van verworven inzichten kunnen vervolgens doelgerichte marketingcampagnes opgezet worden. Ook wil men onderzoeken of gedragsdata van websitebezoekers bekomen kunnen worden en of deze kunnen bijdragen aan doorgedreven personalisatie.
Hans Hoff van TrailFinders heeft deze case spontaan aangebracht na het volgen van een Unizo webinar waar ook het Start2AIM project toegelicht werd.

www.horseholiday.com
hans@horseholiday.com
heleen@horseholiday.com

Belangrijkste learning
Het aanvullen van historische data met gedragsdata – waaronder het klikgedrag op de website – is essentieel om doorgedreven personalisatie mogelijk te maken.
Door gebruik te maken van laagdrempelige analyse- en visualisatietechnieken kunnen reeds eenvoudige, maar zinvolle inzichten verworven worden uit historische data. Dit is de eerste stap alvorens men aan personalisatie kan doen.
Personalisatie use-case
Een belangrijke doelstelling van TrailFinders omvat het in kaart brengen van hun klantenbestand, dat meer dan 1.000 klanten bevat over een periode van meer dan tien jaar. Klantensegmentatie kan hen vervolgens in staat stellen om gerichter te communiceren om zo de Customer Lifetime Value (CLV) te verhogen. Verder wil men ook nieuwe klanten aantrekken door op een gepersonaliseerde manier reisaanbiedingen te brengen, zowel via nieuwsbrieven als op de eigen website en social media.
Vandaag worden klanten van TrailFinders uitsluitend benaderd in functie van een nieuwe of bestaande boeking. Tijdens het maken van een eerste boeking wordt een klantenprofiel aangemaakt in het boekingssysteem, waarna alle activiteiten met de klant uitgebreid, maar manueel gelogd worden. Op die manier kan men nagaan wanneer een boeking aangemaakt, gewijzigd en gefactureerd werd en wat de verschillende reisopties waren waarvoor de klant gekozen heeft. Van elke klant wordt demografische informatie bijgehouden en is er gedetailleerde boekingsinformatie aanwezig, zoals het gefactureerde totaalbedrag, de bestemming, bestel- en vertrekdatum, aantal deelnemers en het type reis.
De aanwezige data (klantinformatie, boekingsdata, en de gelogde informatie) kan gebruikt worden om eerste inzichten te verkrijgen en klanten te segmenteren. Ook kunnen voorspellingen gemaakt worden, zoals de geschatte periode waarbinnen een type klant opnieuw zal bestellen of welke soort reis men kan aanbevelen aan een bepaalde type klanten.

Strategische aanpak
Op het vlak van bedrijfs- en marketingdoelstellingen is nieuwe klanten aantrekken en de bestaande beter leren kennen, van groot belang voor TrailFinders. Hiervoor wil men verzamelde data over een periode van ongeveer 10 jaar optimaal inzetten. Deze data zijn centraal aanwezig in het gebruikte boekingssysteem dat door een externe partner wordt gehost en beheerd. TrailFinders heeft een duidelijk zicht op de aanwezige data en de marketingdoelstellingen, al worden deze data nog niet ingezet om deze doelstellingen te helpen bekomen.
Wat betreft bedrijfs- en datacultuur/-expertise beschikt men intern niet over uitgebreide technische expertise om zelf analyses uit te voeren, al is men er wel van overtuigd dat de aanwezige data zeker kunnen bijdragen om een datagestuurde marketingstrategie mogelijk te maken. Dit vertrouwen wordt gesterkt door het feit dat er per klant en per reis een grote hoeveelheid aan data wordt bijgehouden.
Op regelmatige basis wordt er door een externe partner een SEO-rapport afgeleverd, dat algemene trends aantoont betreffende het websiteverkeer en gebaseerd is op anonieme, geaggregeerde data.
Inzake datamaturiteit (het verzamelen van data, het bewaren en de kwaliteit ervan) is het zo dat de medewerker die de boeking behandelt, deze ook in het boekingssysteem registreert. Tegelijkertijd wordt de klantinformatie opgeslagen wanneer deze nog niet aanwezig was in het systeem. Alle data worden hierdoor op een gestructureerde manier opgeslagen, al laat het systeem in verschillende gevallen lege velden of ongestructureerde waarden toe, wat ertoe leidt dat data niet rechtstreeks bruikbaar zijn en eerst opgekuist moeten worden.
Binnen het boekingssysteem bestaat de mogelijkheid om enkele basisgrafieken te genereren om globale inzichten te verkrijgen. Voorbeelden hiervan zijn het aantal boekingen per jaar en de verworven omzet. Deze informatie is erg algemeen en bijgevolg niet erg nuttig voor analysedoeleinden.
Onderstaande tabel geeft de door TrailFinders gebruikte systemen weer:
Systeem | Vendor | Type data |
CRM + ERP | TravelNote | Klantinformatie Activiteitenlog Boekingen |
Web analytics | Google Analytics | Geaggregeerde website analytics |
Aan de slag met de data
Allereerst werd door middel van een RFM-analyse het bestaande klantenbestand in kaart gebracht. Hieruit volgde dat het grootste deel van de klanten een- of tweemaal bestelt, met als uitzondering een kleine groep klanten die heel trouw bijna jaarlijks bestellen. In een volgende stap wil men aan de hand van een Machine Learning algoritme op basis van de bestaande data voorspellen binnen welke periode een bepaald type klant opnieuw boekt.
Volgende data uit het bestelplatform worden hiervoor gebruikt:
- Klantinformatie: leeftijd, woonplaats, datum aanmelding.
- Boekingen: bestelbedrag, bestemming, datum heen- en terugreis, aantal deelnemers in het gezelschap, type reis.
Voor de uitwerking van dit scenario is gebruik gemaakt van een gratis open source machine learning-bibliotheek (Scikit-learn, 2021c) die kan gebruikt worden wanneer men ontwikkelt in de Python-programmeertaal. Python is een van de meest gebruikte programmeertalen en erg geschikt voor data-analyse en Machine Learning.
De combinatie van Python en Scikit-learn geeft de ontwikkelaar veel flexibiliteit, al is er een aanzienlijke technische kennis vereist om hier zelf mee aan de slag te gaan. Customer segmentation zit vaak ook ingebouwd in marketing-tools en CRM-systemen, waardoor KMO’s hiermee op een laagdrempelige manier mee aan de slag kunnen gaan.
Welke resultaten werden hiermee behaald? Allereerst worden alle unieke klanten in het systeem bepaald: van sommige klanten zijn dubbele records beschikbaar en helpt de combinatie van naam, adres en telefoonnummer deze uniek te identificeren. Per klant worden vervolgens al haar/zijn gemaakte reizen gegroepeerd.
Per reis is volgende informatie beschikbaar:
- Datum boeking
- Totaalprijs
- Vertrekdatum en datum terugkomst
- Bestemming (wordt niet gestructureerd bijgehouden)
- Type reis (wordt niet consistent ingevuld)
Aangezien de bestemming en het type reis niet gestructureerd aanwezig zijn, kan van deze kolommen niet rechtstreeks gebruik gemaakt worden. De overige kolommen zijn wel geschikt om als features gebruikt te worden bij het voorspellen van een volgende boekingsdatum.
In een volgende stap wordt het aantal dagen tussen meerdere boekingen per klant berekend. Dit laat toe om ook het gemiddelde en de standaardafwijking te berekenen en later ook mee op te nemen als feature.
Uiteindelijk worden volgende features meegenomen in de voorspelling:
- Aantal dagen tussen iedere boeking, samen met het gemiddelde en de standaardafwijking
- Leeftijd klant
- Gemiddeld aantal deelnemers en hun gemiddelde leeftijd
- Recency: het aantal dagen sinds de laatste boeking
- Frequency: aantal geboekte reizen
- Monetary value:
- Totaalprijs per reis
- Totaalprijs per reis en per deelnemer
De te voorspellen waarde (of label) is de tijd waarbinnen een klant opnieuw boekt. Na analyse en visualisatie van de data zijn volgende intervallen arbitrair vastgelegd:
- Label 1: Tussen 0 en 200 dagen.
- Label 2: Tussen 200 en 350 dagen.
- Label 3: Meer dan 350 dagen.
Het doel is om zo nauwkeurig mogelijk te voorspellen welk label (tijd tot volgende bestelling) hoort bij welk type klant (gekenmerkt door zijn bijhorende features). De kwaliteit van deze voorspelling wordt geëvalueerd aan de hand van de accuraatheid (of accuracy), wat een maat is voor het aantal correct gemaakte voorspellingen door het algoritme.
Er worden vervolgens meerdere Machine Learning modellen getraind, waarna datgene dat het best presteert, automatisch uitgekozen wordt. Het best presterende Machine Learning model is XGBoost en biedt een accuraatheid van 78%, wat betekent dat voor 78% van de klanten een correcte voorspelling werd gemaakt.
De technische uitwerking van deze use-case kan verder uitgebreid worden wanneer de nodige informatie ter beschikking wordt gesteld:
- Voorspellen welk type reis het best past bij welk type klant (gestructureerde reisinfo is vereist).
- Voorspellen welke regio’s geïnteresseerd zijn in welke aanbiedingen (gestructureerde klantinfo is vereist).
Op basis van deze voorspellingen kan vervolgens gepersonaliseerd gecommuniceerd worden: klanten die volgens de voorspelling al opnieuw zouden moeten boeken maar dit nog niet deden, kunnen een korting ontvangen om te gebruiken bij hun volgende reservatie (campaign targeting). Dit kan men combineren door meteen reizen aan te bevelen die gelijkaardig zijn aan de eerder geboekte (content personalisatie).

Bijkomende suggesties
Rond deze use-case werd een panelgesprek georganiseerd met de technische partners van het Start2AIM-project. Vertrekkende van de beoogde doelstellingen en beschikbare data van TrailFinders werd nagegaan wat hun digitale maturiteit is en welke stappen in de toekomst nog ondernomen dienen te worden om hun doelen te bereiken.
Hieruit bleek dat TrailFinders beschikt over een grote hoeveelheid historische data, waar op dit moment reeds enkele analyses kunnen op uitgevoerd worden om bijvoorbeeld trends te detecteren. Toch volstaan louter historische data niet wanneer men aan doorgedreven personalisatie wil doen om de klantenloyaliteit te verhogen en nieuwe klanten aan te trekken. Historische data geven inzichten met betrekking tot bestaande klanten en helpen niet zozeer bij het aantrekken van nieuwe klanten.
Om meer inzicht te krijgen in het soort reis waar een bepaald type gebruiker naar op zoek is, is het een vereiste om gedragsdata bij te houden en te focussen op de stappen binnen het conversieproces.
Mailings
Voor het uitsturen van algemene nieuwsbrieven wordt gebruikt gemaakt van Mailchimp. Binnen deze tool kunnen de klanten al op een manuele manier in basissegmenten geplaatst worden, bijvoorbeeld op basis van het type reizen dat in het verleden gemaakt werd en de bijhorende prijsklasse.
Website
Als startpunt dient Google Analytics correct geconfigureerd te worden, waarbij conversiedoelen duidelijk gedefinieerd moeten worden. Dit zal helpen om de customer journey in kaart te brengen. Zo kan ook gedetecteerd worden welk type pakketten al dan niet in de smaak vallen bij klanten, waarna deze op gepaste wijze aangepast kunnen worden.
Daarnaast kan men ook gebruik maken van UTM-tags. Dit zijn korte stukjes tekst die toegevoegd kunnen worden aan links op de website. Zij voegen extra informatie toe over websitebezoekers. Vervolgens kan Google Analytics deze tags herkennen om te detecteren op welke link of knop websitebezoekers geklikt hebben alvorens ze op de TrailFinders website terecht gekomen zijn.
Volgende 5 UTM parameter worden door Google Analytics herkend:
- utm_campaign: geeft de specifieke marketingcampagne aan (bijvoorbeeld “winterverkoop”), waardoor de effectiviteit ervan kan nagegaan worden.
- utm_medium: het medium waarlangs de bezoeker op de website is terechtgekomen (social, email, …).
- utm_source: geeft de bron van het websiteverkeer aan (‘google”, ”instagram”, ”twitter”) en voegt op die manier specifieke informatie toe aan de utm_medium parameter.
- utm_term: geeft aan via welke zoektermen bezoekers op de website terechtgekomen zijn (bv. utm_term = korting_op_safari_reizen). Deze parameter wordt vooral gebruikt in combinatie met Google AdWords.
- utm_content: geeft aan via welke call-to-action bezoekers op de website terechtgekomen zijn (bv. “meer informatie” of “reserveer vandaag”). Deze parameter laat toe om te bepalen welke call-to-action het beste werkt.
Daarnaast is het ook nodig om van klanten zoveel mogelijk informatie bij te houden, zelfs nog voor ze een reis boeken, waaronder:
- Klikgedrag op de website.
- Tijdsduur sessie.
- Toestel waarmee men de website bezoekt.
- Tijdstip wanneer men de website bezoekt.
Het aanvullen van de bestaande historische data met gedragsdata is noodzakelijk om aan doorgedreven personalisatie te doen.
Conclusies
Historische data zijn reeds een grote hulp om meer inzichten in het klantenbestand te krijgen en kunnen helpen om het klantenbestand te segmenteren. Verder kan men op die manier lopende trends makkelijker detecteren en hierop inspelen.
Wanneer men haar/zijn klanten wil leren kennen en nieuwe klanten wil aantrekken, is het een vereiste om op een actieve manier bijkomende gedragsdata bij te houden. Dit impliceert een aanzienlijke inspanning op strategisch en technisch niveau.
Data moeten vandaag, maar ook in de toekomst, gestructureerd bijgehouden worden, wat vooral een inspanning op strategisch vlak vereist. Het bijhouden van data onder gestructureerde vorm is daarbij erg belangrijk en kan op technisch vlak uitgevoerd worden door te werken met dropdowns.
Je droomhuis aan de Spaanse Costa’s vindt jou.
Wie wil nu geen luxevilla aan de Spaanse Costa’s? Je weg vinden in het gigantische aanbod is echter niet evident. Misschien vindt je droomhuis jou wel via een ingenieuze recommendation engine.
Deze case draait om een aankoopmakelaar voor Spaans vastgoed. Ze begeleiden potentiële kopers uit België en Nederland die op zoek zijn naar een luxueus, tweede verblijf doorheen de chaotische Spaanse vastgoedindustrie. Door hun klantgeoriënteerde, objectieve en transparante dienstverlening zorgen ze ervoor dat kopers goed geïnformeerd het aankoopproces kunnen aanvatten.
In tegenstelling tot de traditionele makelaars werkt men met onafhankelijke experten die de koper vertegenwoordigen en adviseren. Er wordt steeds gestart vanuit een grondige screening van de lokale aanbieders waarbij enkel bij positief advies het vastgoed van deze lokale spelers wordt opgenomen in het aanbod.
Door gebruik te maken van een recommender systeem wil de makelaar zich onderscheiden binnen de concurrentiële vastgoedmarkt.
Deze use-case werd uitgewerkt en aangeboden door WebFaster.

www.webfaster.com
yannig@webfaster.com
timothy@webfaster.com
Belangrijkste learning
- Het belang van een goede gebruikerservaring mag niet onderschat worden. Het aanbieden van een goede, klantgerichte service is essentieel om hogere verkoopcijfers te realiseren.
- Het bijhouden van alle klanteninteracties doorheen het gehele aankoopproces blijkt cruciaal om op basis hiervan een gepersonaliseerde aanpak te kunnen bieden.
- De prioriteit ligt niet noodzakelijk op het inzetten van het beste algoritme. Het louter plaatsen van recommender boxes (“aanbevolen voor jou”), kan al tot een significante stijging in conversies leiden omdat dit het aantal mogelijke touchpoints verhoogt.
E-mail en personalisatie van de website
De vastgoedindustrie is erg concurrentieel, waardoor het belangrijk is zich te onderscheiden van de traditionele spelers op de markt. De vastgoedmakelaar wil dit realiseren door gebruik te maken van technologie om de klanten efficiënter en persoonlijker te kunnen begeleiden doorheen het gehele aankoopproces. Ook kunnen er verdere schaalvoordelen behaald worden, zowel op het vlak van marketing automation (met onder meer lead scoring, recommendations en mailings), als door process automations.
“Meten is weten”: het is belangrijk dat bestaande flows eerst in kaart gebracht worden. Om hiertoe te komen werd een datacollectiestrategie uitgewerkt.
Om een overzicht te behouden van alle klantinteracties, werd er naast het bestaande CRM-systeem een custom admin dashboard gebouwd om meer informatie over panden en interacties met gebruikers bij te kunnen houden.
Op basis van de gedragingen van anonieme bezoekers op de website werd vervolgens een personalisatiestrategie voor de website uitgewerkt (content personalisatie). Deze werd gecombineerd met een personalisatiestrategie voor e-mail om de gebruiker doorheen de gehele flow een zo persoonlijk mogelijke service te bieden (campaign targeting).
Aan de slag
Samen met de vastgoedmakelaar werd er gekeken naar de doelstellingen en de huidige stand van zaken betreffende datacollectie.
In de ideale situatie zorgt het implementeren van technologie ervoor dat repetitieve en tijdrovende taken van de makelaar zo goed als mogelijk worden geëlimineerd. De doelstelling is dan ook om technologie als aanvulling bovenop de menselijke skills te kunnen inzetten in plaats van louter mensen te vervangen door technologie. Op die manier kan een prospect bij elke interactie zo goed mogelijk ondersteund worden.
Data collectie
Om hyperpersonalisatie mogelijk te maken moeten er voldoende kwalitatieve data beschikbaar zijn. Deze datacultuur was al sterk aanwezig en er werden over de verschillende divisies heen (van marketing tot sales) op een gestructureerde manier data verzameld:
- Campaign info: Google Search Ad Campaigns, Facebook Ads
- Website Analytics en tracking: Google Analytics, Facebook Tracking Pixel
- Klant- en verkoopsdata: Hubspot CRM
Bij aanvang bleek website tracking nog niet op alle pagina’s correct geconfigureerd te zijn en ook waren nog niet alle conversies bepaald en ingesteld in Google Analytics.
Bovenop Google Analytics werd een custom tracking snippet toegevoegd, waardoor elke interactie en conversie getracked kon worden. Er werd gekozen voor een custom snippet omdat dit ontwikkelaars een pak meer vrijheid biedt rond configuratie en functionaliteiten. Zo is het naast het tracken van clicks ook mogelijk om aanvullende metadata te tracken: per gebruiker kan nagegaan worden welke pagina’s er op welk moment bekeken werden. Hoewel via Google Analytics reeds een handig overzicht bekomen kon worden, kon daar niet erg diepgaand ingegaan worden op het surfgedrag op gebruikersniveau.
In het datacollectieproces is het belangrijk dat alle conversies op de site in kaart worden gebracht. Dit zijn onder meer:
- E-book downloads
- Verzonden contactformulieren
- Nieuwsbrief abonnees
- Mensen die een profiel aanmaken
Door hier tracking op te activeren, kan achterhaald worden welke stappen uiteindelijk leiden tot deze conversies. Ook in functie van latere A/B-testing is het belangrijk om een soort baseline of referentiewaarde te hebben wat betreft conversies. De conversion rate is samen met de click through rate (CTR) een belangrijke metriek. Op die manier kan gedetecteerd worden welke verbeteringen aan de user interface eventueel leiden tot een stijging van de conversies.
Er werd uiteindelijk een custom Data Management Platform (DMP) opgezet, waarbij alle interacties en bijhorende data worden weggeschreven naar een centrale database. Deze data worden vervolgens verstuurd naar het admin dashboard, van waaruit er gesynchroniseerd wordt met het CRM-systeem.
Admin dashboard met customer interactions
Omdat het in Hubspot niet mogelijk was om de te verkopen panden te matchen met de gebruikers, en het evenmin mogelijk was om metadata van panden bij te houden of te filteren, werd er een custom admin dashboard ontwikkeld, waar personeelsleden van de makelaar alle informatie terugvinden over de panden, contacten en de interacties. Bij uitbreiding dient dit admin dashboard ook als een CMS-systeem waarmee de medewerkers de getoonde panden op de website kunnen beheren.
Het admin dashboard dient als het centrale brein van de operatie, van waaruit de verschillende marketing automation acties kunnen worden aangestuurd. Zo is het onder meer mogelijk om op pandniveau potentiële kopers te bekijken.
Op gebruikersniveau kan het volgende gevisualiseerd worden:
- de gebruikers die het pand hebben bekeken
- de panden die aangeduid worden als favoriet
- de panden die matchen met hun interesses
Personalisatiestrategie voor website
Het doel van de websitepersonalisatie was om aan de hand van het zoek- en klikgedrag van de gebruiker interessante panden aan te bevelen op verschillende plaatsen op de website.
Allereerst werd per websitebezoeker één profiel bijgehouden, dat toelaat om na te gaan welke panden, locaties en blogs bekeken werden. Er werd ook een vragenlijst online gezet waarbij de gebruiker naar zijn of haar ideale vastgoed wordt geleid. Deze verkregen klantinformatie wordt opgeslagen in het DMP.
Voor het uitwerken van aanbevelingen werd gebruikgemaakt van een K-Nearest-Neighbour (KNN) user based algoritme (Scikit-Learn, 2021b). Dit algoritme werd gekozen op basis van eerdere ervaringen. Panden kunnen aanbevolen worden op basis van het zoekgedrag van bezoekers. Meer concreet krijgt men als bezoeker panden te zien die personen met hetzelfde interesseprofiel hebben bekeken.
Het doel van het tonen van deze aanbevelingen is om de gebruiker makkelijker te sturen richting het vastgoed dat past bij hem of haar. Om het slaagpercentage na te gaan, werd een A/B-test opgezet waarbij slechts de aanbevelingen voor de helft van de gebruikers gepersonaliseerd werd. Deze groepen werden willekeurig toegewezen. Vervolgens werd gekeken naar het verschil in conversies en surfgedrag tussen de twee groepen en werd op basis hiervan de uplift berekend.
Zoals bij elke recommendation engine is er ook in dit geval sprake van Cold Start problemen, waarbij er in het begin nog te weinig data aanwezig zijn in het systeem opdat er accurate voorspellingen gemaakt kunnen worden. Hierbij is het dus lastig om aanbevelingen te doen naar aanleiding van nieuw geïntroduceerde panden en/of gebruikers.
- Op itemniveau (panden) werd getracht dit op te lossen door op basis van de vele metadata (onder andere locatie, aantal slaapkamers, afwerking, zeezicht) nieuw geïntroduceerde items (panden) te matchen met items die reeds aangeraden werden aan gebruikers (en waarvoor dus al een similarity score werd berekend). Op deze manier kunnen nieuwe items nagenoeg meteen opgenomen worden in de aanbevelingen.
- Wat betreft users (websitebezoekers) vormt dit een grotere uitdaging. Alles op de website is zo opgezet dat heel snel veel informatie verzameld en verwerkt kan worden met betrekking tot de interesses van de bezoeker (o.a. de mogelijkheid om gebruikersprofielen aan te maken en voorkeuren op te slaan). In het begin zal een gebruiker enkel gerelateerde panden aanbevolen krijgen op pandniveau. Hoewel dit minder goed werkt dan het finale algoritme, kan toch opgemerkt worden dat het louter aanwezig zijn van deze extra touchpoints (de plaatsing van de recommendation box) op zich al leidt tot extra conversies (ongeacht of de aanbevelingen nu hyper-gepersonaliseerd zijn of eerder vrij algemeen).
Personalisatie van e-mail
Het personalisatieverhaal begint met de website. Dankzij het ontwikkelde admin dashboard kan de makelaar een uitgebreid zoekprofiel aanmaken voor gebruikers waarvan ze de contactgegevens hebben verkregen. Door deze informatie te matchen met het gedrag van gebruikers op de website is men in staat om een heel gericht zoekprofiel op te stellen.
Door de profielen vervolgens te matchen met het nieuwe aanbod kan er volledig geautomatiseerd een gerichte mail worden verstuurd naar de gebruikers. Momenteel wordt deze e-mail verstuurd op aanvraag van de makelaar. De open rates en click through rates (CTRs) worden wel bijgehouden om in een later stadium ook het optimale tijdstip van versturen te kunnen bepalen.
Conclusies
Het doorlopen van dit personalisatie-traject heeft ervoor gezorgd dat de makelaar een sterk verbeterde klantervaring kan bieden. Zaken die voorheen heel wat tijd in beslag namen, kunnen nu geautomatiseerd worden. Daarnaast hebben medewerkers een sterk verbeterd overzicht van de leads waarmee ze in contact zijn.
Toch blijven er ook uitdagingen bestaan. Hoewel er een sterke datacultuur aanwezig was, blijft het enorm belangrijk om data op een consistente en gestandaardiseerde manier op te slaan. Ook bij het aanpassen van de website moet men er op toezien dat alles correct wordt getracked en in kaart gebracht. Binnen het CRM systeem zouden nog meer controlechecks moeten geïmplementeerd worden zodat elke klantinteractie op de juiste manier gelogd wordt.
Een mogelijkheid naar de toekomst toe is om aan profile enrichment te doen door voor elke nieuwe lead automatisch third-party data binnen te halen van verschillende externe bronnen en deze te presenteren in het CRM-systeem. Dit kan men bekomen door aan de hand van online tools persoonlijke en business data van personen op te halen (bv. FullContact, NBB database, Google queries), al blijft GDPR hier zeker een aandachtspunt. Hierdoor kunnen klanten nog persoonlijker aangesproken worden en kunnen de interessantste leads prioritair benaderd worden.
Smaken verschillen: de juiste wijn aanbevelen aan de juiste klant.
Het aanbieden van gepersonaliseerde aanbevelingen aan klanten in de winkel gaat een succesvolle verkoop vooraf. Maar wat als de wijnhandelaar al een andere klant aan het helpen is? Of wat als je online aan het wijnshoppen bent?
Een wijnhandelaar heeft enkele vestigingen in verschillende gemeenten in Vlaanderen. Ze leveren zowel aan B2B-klanten (vooral binnen de horecasector) als aan consumenten, en dit zowel offline als online. Deze case richt zich op het consumentenluik van hun business.
Om zich te onderscheiden van andere handelaars, wil men klanten binnen de online verkoop zo goed mogelijk begeleiden in hun zoektocht naar de meest geschikte wijn. Door het inzetten van AI kunnen gepersonaliseerde aanbevelingen aangeboden worden. Hiervoor is kennis nodig over de verschillende wijnen, de voorkeuren van de consument en eventuele gerechten waarbij de wijn kan geconsumeerd worden. Deze gepersonaliseerde aanpak wenst men zowel via de webshop als via nieuwsbrieven te realiseren.
Deze use-case werd uitgewerkt en aangeboden door Cropland.
www.cropland.be
geert@cropland.be
Belangrijkste learning
Een klant kan zowel in de winkel als op de website wijn aankopen. De koppeling tussen de online en offline verkoopdata in één centraal kassaregistratiesysteem is vereist om personalisatie te realiseren over verschillende kanalen heen.
Vooraleer er efficiënt gebruik kan gemaakt worden van AI, moet gestructureerde informatie bijgehouden worden over alle wijnen, zoals hun karakteristieken, bijpassende gerechten en sterke tekstuele beschrijvingen.
Een datacultuur moet blijvend onderhouden worden. Zo moeten data consistent verzameld worden, zelfs op momenten wanneer het erg druk is (bijvoorbeeld op een braderij waar er enkel cash betaald kan worden en de transactiedata dus niet automatisch opgeslagen worden).
Gepersonaliseerde aanbiedingen, zowel online als offline.
Consumenten kopen doorgaans wijn om zelf te consumeren of om cadeau te geven. Voorafgaand aan de aankoop moeten er telkens enkele keuzes gemaakt worden:
- Heeft men een voorkeur voor een bepaald type wijn? (wit, rood, rosé).
- Welke smaakaccenten wil men terugvinden?
- Bij welke gerechten moet de wijn passen?
- Welk bedrag wil men spenderen?
De centrale doelstelling van deze personalisatiecase is het aanbieden van wijnen aan de consument die afgestemd zijn op zijn of haar persoonlijke voorkeuren, dit zowel via offline als online kanalen.
Bij de offline verkoopkanalen (in de vestigingen of op braderijen) is het de taak van de winkelbediende om het keuzeproces te begeleiden. De winkelbediende beschikt over een uitgebreide kennis van de wijnen, al zijn er nog enkele uitdagingen aanwezig:
- Het aantal wijnen en de bijhorende hoeveelheid aan informatie is groot. Hoe kan daar op een efficiënte manier mee omgegaan worden om de ideale wijn te kiezen?
- Op wijnproefdagen is er niet altijd onmiddellijk een winkelbediende beschikbaar voor elke klant. Hoe kan de consument alsnog geholpen worden in de zoektocht naar de juiste wijn?
Via de online verkoopkanalen wenst men twee types personalisatie te realiseren:
- Content personalisatie: Het aanbieden van dezelfde kwalitatieve en gepersonaliseerde service op de webshop als in de winkel.
- Campaign targeting: Het versturen van persoonlijke aanbevelingen en aanbiedingen via nieuwsbrieven.
Strategische aanpak
Het opzetten van een AI-traject start bij het definiëren van de doelstellingen en het opzetten van een datacultuur.
Wat betreft de bedrijfs- en marketingdoelstellingen, is het voor de wijnhandelaar essentieel om de klant zo persoonlijk mogelijk te benaderen. Op die manier kan men zich onderscheiden van andere, grotere spelers op de markt. Dit uit zich in een verhoogde klantenloyaliteit, wat gepaard gaat met een verhoogde omzet. Bij offline verkoop kan de winkelbediende een inschatting proberen te maken van de wensen van de klant, iets wat een grotere uitdaging vormt wanneer men online verkoopt.
Inzake bedrijfs- en datacultuur/-expertise is de stap van wijn verkopen naar het integreren van data als centrale bron, groot en vergt die een aanzienlijke inspanning. Tot op heden was er nog geen interne of externe expertise aanwezig wat betreft data, AI, of personalisatie. Het gebruik van data beperkte zich tot het invullen van wijninformatie in excel-bestanden en het verzamelen van met balpen ingevulde formulieren tijdens wijnproefdagen. Deze verzamelde informatie werd niet steeds consistent gedigitaliseerd en gecentraliseerd, waardoor het potentieel van deze data niet volledig kon benut worden.
Het feit dat de webshop reeds verbonden was met het fysieke kassaregistratiesysteem en dat de data dus digitaal beschikbaar zijn, berustte eerder op toeval, maar bleek wel een cruciaal element in de uitwerking van deze case. Dit liet immers toe om personalisatie eenvoudig te laten doorvloeien via offline en online kanalen, met een beperkte inspanning van de winkelbedienden.
Aan de slag met de data
Dankzij het gebruik van APIs kon wijninformatie op de webshop eenvoudig opgevraagd worden en gevoed worden door een AI-algoritme. Vervolgens konden ook de bekomen resultaten en inzichten teruggestuurd worden naar het systeem van de wijnhandelaar. Deze technische implementatie maakte dat de output van het ingezette algoritme heel vlot bruikbaar werd in de dagelijkse praktijk.
Vertrekkende van de verzamelde data over een periode van één jaar (klantinformatie en de bijhorende bestellingen), werd door een algoritme een aantal klantensegmenten automatisch gedetecteerd en aangemaakt. Dit is een iteratief proces dat opnieuw moet uitgevoerd worden wanneer de data van klanten en wijnen aangepast of aangevuld worden. Door een verdere integratie met het mailprogramma verkrijgt de consument een gepersonaliseerd aanbod, zonder dat de handelaar hier extra tijd aan hoeft te besteden.
Wat hebben deze inspanningen opgeleverd? De gedetecteerde klantensegmenten worden gebruikt in nieuwsbrieven en op de webshop. Daarnaast krijgen winkelbedienden via tablets informatie over de persoonlijke voorkeuren van de consument. Op wijnproefdagen kan de consument een “persoonlijke route” door de wijnen downloaden en afprinten, zo weten ze welke wijnen ze zeker eens moeten proeven.
Dankzij deze gepersonaliseerde aanpak kan de winkelbediende beter inspelen op de wensen van de klant. De klant krijgt de ideale wijn gepresenteerd waardoor de klantenbinding versterkt wordt (wat ook bijdraagt tot de loyaliteit aan deze wijnhandelaar).
Conclusies
Deze case toont aan dat een kleine speler reeds gebruik kan maken van AI, met als belangrijke voorwaarde dat data op een gestructureerde manier verzameld worden over de verschillende offline en online kanalen heen. Een AI-traject is geen eenmalig of tijdelijk project, maar vereist continue inspanningen wat betreft het consistent en gestructureerd bijhouden van data. Daarnaast moet het algoritme ook onderhouden worden wanneer het nieuwe informatie gevoed krijgt, wat voor kleine ondernemingen een grote uitdaging kan vormen. Een mogelijke oplossing hiervoor zou kunnen liggen in de rechtstreekse integratie van dergelijke voorspellingsalgoritmen in kassaregistratiesystemen en webshopaanbieders onder de vorm van kant-en-klare plugins. Op die manier wordt deze functionaliteit op een laagdrempelige manier aangeboden zonder dat technische kennis vereist is.
Een idee voor de toekomst is om de consument in de handelszaak een preselectie te laten maken via een tablet. Dit komt neer op een self-service zonder dat men de negatieve aspecten – zoals bijvoorbeeld onpersoonlijkheid – hiervan ervaart. De website kan vervolgens ook voorzien worden van een wizard waarbij de beste wijnkeuze wordt gesuggereerd aan de hand van een zelf samengesteld menu. Om goede resultaten te bekomen, zal op technisch vlak beroep gedaan worden op Natural Language Processing (NLP) om wijnbeschrijvingen te verwerken.
De grootste uitdaging bleek het bekomen van relevante AI-inzichten in de dagelijkse praktijk: bij elke update in het systeem (nieuwe informatie over klanten, bestellingen en wijnen), moeten de data opnieuw verwerkt en geanalyseerd worden. Dit blijkt een grote uitdaging te zijn op zowel operationeel als financieel vlak.
Je klanten offline én online beter leren kennen.
Wie zijn jouw beste klanten en wie kan wel een extra duwtje in de rug gebruiken? Door je klanten op te delen in verschillende segmenten en na te gaan of een klant binnen een bepaalde periode terechtkomt in een ander segment, kan je tijdig en gericht communicatie- en marketingacties opzetten voor hen.
Anna Pops verkoopt unieke en duurzame kleding voor modebewuste kinderen en moeders via een eigen winkel en webshop. Ze onderscheiden zich van de grotere spelers doordat ze een verregaande persoonlijke service leveren wanneer klanten komen shoppen in de fysieke winkel. Anna Pops kent immers ondertussen heel wat klanten en bouwde een persoonlijke band op met hen. Het doel is om hun klanten zoveel mogelijk te ontzorgen en een leuke shopervaring aan te bieden.
De klanten van Anna Pops zijn erg divers, gaande van eenmalige bestellers tot erg loyale klanten. Binnen het klantenbestand zijn er ook klanten die meer aandacht nodig hebben of lijken weg te vallen. Om elk type klant zowel offline als online gerichter te kunnen aanspreken, wil Anna Pops deze klantengroepen in kaart brengen en eventuele wijzigingen hierin automatisch detecteren. Vervolgens wil men de communicatie hier gericht op gaan afstemmen.
Deze use-case werd door het Start2AIM-team aangebracht en werd technisch uitgewerkt door Cnext.

www.annapops.be
info@annapops.be
Belangrijkste learning
- Datavisualisatie is steeds de eerste stap om zinvolle inzichten te verwerven en samen met de klant te redeneren over zinvolle use-cases.
- Het is essentieel om van bij start goed na te denken over de te gebruiken datastructuren en om deze structuren zo logisch mogelijk te ontwikkelen. Op die manier kunnen ook op een later moment – wanneer de activiteiten en het klantenbestand groeien – waardevolle analyses uitgevoerd worden.
- AI moet steeds een hulpmiddel zijn en geen doel op zich. Start daarom kleinschalig met iets wat al vrij snel een meerwaarde kan opleveren. Op die manier kan ook op een efficiënte manier opgeschaald worden naar iets grotere projecten.

Het gedrag van klanten helpen detecteren.
Anna Pops heeft een ruim klantenbestand van zowel online als offline bestellers. Men wil zich onderscheiden van andere kledingzaken door de klant op een zo vrijblijvende, maar persoonlijke manier te ontzorgen. Bij fysieke winkelbezoeken kan men hierop inspelen doordat men de klant dikwijls persoonlijk kent en daardoor een goede inschatting kan maken. Voor de minder loyale en online klanten blijft dit in veel gevallen echter nog een uitdaging. Ook wanneer nieuwe winkelbedienden klanten bijstaan, is meer informatie aangewezen.
Op basis van historische aankoopdata kan op een automatische manier aan klantensegmentatie gedaan worden. Op die manier behoort elke klant tot een segment op basis van het aankoopbedrag en hoe recent en frequent men besteld heeft. Door vervolgens wijzigingen in dit gedrag te detecteren, kunnen klanten die aandacht nodig hebben, heel eenvoudig aangesproken worden.
Dit staat Anna Pops toe om haar marketingstrategie en communicatie te optimaliseren. De focus hoeft bij trouwe klanten misschien minder te liggen op promoties, maar eerder op het introduceren van nieuwe producten of diensten. Klanten die dreigen af te haken, dienen dan weer verleid te worden met een onweerstaanbaar voorstel om opnieuw te bestellen.
Strategische aanpak
De belangrijkste doelstelling van Anna Pops is om klanten zowel offline als online te ontzorgen en een kwalitatieve service aan te bieden. Het aanbieden van een gepersonaliseerde aankoopervaring zal op haar beurt de klantenbinding verhogen en leiden tot een stijging van de omzet.
Anna Pops beschikt over uitgebreide historische data over een periode van meer dan zeven jaar. Deze data omvatten klantinformatie en de data rond betalingen (zowel voor offline als online aankopen), en worden opgeslagen in een custom-made systeem. Dit systeem is opgezet bij de start van de zaak door een externe partner, die tot op vandaag ook verantwoordelijk is voor het onderhoud ervan. Aangezien niet alle aanwezige data automatisch gekoppeld zijn aan elkaar, dient eerst een pre-processing stap te gebeuren waarbij alle orders correct gekoppeld worden aan de juiste klanten. Anna Pops is zich bewust van het belang van data en de daaruit voortvloeiende analyses, al vereist dit ook steeds de nodige investering wat betreft tijd en middelen.
Vertrekkende van deze data worden in PowerBI vandaag al geaggregeerde rapporten gegenereerd die iets meer vertellen over het algemene koopgedrag.
Aan de slag met de data
RFMT-analyse
Bij klantensegmentatie wordt doorgaans naar het gehele klantenbestand gekeken over de volledige aankoopperiode. Een van de meest gebruikte methoden om deze clusters te bekomen, omvat het bijhouden van RFMT-variabelen per klant:
- Recency: Het aantal dagen sinds de laatste aankoop.
- Frequency: Het aantal geplaatste bestellingen per maand sinds de eerste aankoop.
- Monetary value: De totale omzet.
- Tenure: Het aantal dagen dat men klant is.
Dit is een ideaal startpunt voor de analyse omdat het een goed beeld geeft van de verschillende klantengroepen binnen de onderneming. Vertrekkende van deze groepen (die gekenmerkt zijn door middel van een gemiddelde RFMT-waarde), kan men beginnen te reflecteren over de klantenverdeling en hoe die zich ten opzichte van elkaar verhouden.
In het geval van Anna Pops werden vijf clusters geïdentificeerd, die worden benoemd met de letters A,B,C,D en E. Klanten met gelijkaardige RFMT waarden behoren zo tot dezelfde cluster. De klanten die het meest recent, frequent en voor het grootste aankoopbedrag bestelden, behoren tot cluster A. De aflopende clusters bevatten de klanten volgens aflopende RFMT-waarde. Deze clustering helpt Anna Pops om gericht marketingacties op te zetten.
Gedragswijzigingen herkennen
In een volgende fase tracht men te detecteren welke klanten van aankoopgedrag veranderden.
Hiervoor wordt een bepaalde periode gedefinieerd die als vergelijkingsperiode of baseline moet gelden. In het geval van Anna Pops werd voor een periode van 36 maanden gekozen. Voor deze periode wordt vervolgens een RFMT-analyse uitgevoerd, die een globaal beeld geeft over het klantenbestand van Anna Pops.
Om gedragswijzigingen van deze klanten te analyseren, wordt deze baseline vergeleken met de huidige periode. De lengte van de huidige periode is in dit geval vastgelegd op 12 maanden en moet telkens door de marketingafdeling van het bedrijf gedefinieerd worden. Deze periode is namelijk sectorgebonden en afhankelijk van algemene aankooptendenzen.
Men kan het globale gedrag van een klant (in de baseline over 36 maanden) vergelijken met zijn huidige gedrag (over de laatste 12 maanden) door na te gaan of deze terechtgekomen is in een ander klantsegment. Wanneer men bijvoorbeeld merkt dat iemand die gekend stond als een A-klant, maar binnen de huidige periode gedefinieerd wordt als een D-klant, dient men hierop in te spelen door de gepaste marketingacties op te zetten.
Deze gedragswijzigingen, en de klanten die deze ondergaan, kunnen voorgesteld worden als gedragsgroepen:
Gedragsgroep | Beschrijving | Voorbeed transitie |
Top | Deze klanten waren en blijven topklanten | (geen transitie) |
Nieuw | Nieuwe klanten binnen de huidige periode | (niet van toepassing) |
Aandacht nodig | Klanten die een transitie maken naar een lager segment | B ▶ C |
Groeiend | Klanten die een klantsegment hoger gaan | D ▶ C |
Loyaal | Klanten die geen gedragswijziging kennen (uitgezonderd Nieuw, Top en Slapend) | C ▶ C |
Slapend | Klanten die terugvallen naar het laagste klantsegment | B ▶ E |
Aangezien niet elke klant met evenveel urgentie behandeld moet worden, kunnen gedragswijzigingen ook een Priority-vlag toegekend krijgen. Deze vlag is afhankelijk van het aantal klantensegmenten dat men zakt en het originele klantensegment waartoe men behoort. Zo zal iemand die voorheen een A-klant was en vandaag een B-klant is, een hogere prioriteit genieten dan iemand die overgaat van het D- naar E-klantensegment.
De gedragsgroepen worden als cirkels gevisualiseerd in de onderstaande figuur, waarbij de grootte het aantal klanten aangeeft binnen deze groep. Wanneer een cirkel met een andere verbonden is, geeft het cijfer boven de verbindingslijn het aantal klanten aan dat van gedrag is veranderd. Zo is te zien dat er momenteel 356 klanten Top zijn en 813 Aandacht nodig hebben. Binnen de huidige periode van 12 maanden zijn er 451 klanten overgegaan van Top naar Aandacht nodig. In deze gedragsgroep merken we verder ook op dat er 140 van hen een Priority-vlag kregen (zichtbaar door het gevarensymbool). Deze klanten dienen een hogere prioriteit te krijgen aangezien deze de grootste transitie in koopgedrag vertonen.

Conclusies
Een traditionele RFM(T) analyse geeft al zinvolle inzichten inzake het koopgedrag van klanten. Deze analyse is evenwel een momentopname, waardoor men geen gedragswijzigingen kan detecteren. Door deze analyse herhaaldelijk uit te voeren over verschillende periodes (die zinvol zijn vanuit een marketingperspectief en afhankelijk van de sector), kan men hier tijdig en gericht op inspelen.
Door gebruik te maken van historische aankoopdata, kan men een beeld scheppen van mogelijke nuttige, toekomstige stappen, zonder dat er meteen veel tijd en geld moet geïnvesteerd worden in geavanceerde analyses. In een volgende fase zou men ook gedragsdata (zoals surfgedrag op de website) kunnen opnemen om een meer diepgaande analyse uit te voeren.
Deze aanpak kan vervolgens geautomatiseerd worden zodat de winkelbedienden op regelmatige basis een overzicht krijgen van gedragsveranderingen van klanten, samen met de prioritaire acties. Op basis hiervan kunnen gerichte online en offline acties opgezet worden.
Content in real time aanpassen op maat van de websitebezoeker.
Wat als je je websitebezoekers zou kunnen verwelkomen met gerichte en gepersonaliseerde informatie? Odisee onderzoekt hoe haar website aangepaste inhoud kan tonen voor elke doelgroep om hen zo sneller te laten overgaan tot conversie.
Odisee is een hogeschool die meer dan 10.000 studenten telt en verspreid is over zes campussen in Vlaanderen en Brussel. Men kan er praktijkgerichte opleidingen volgen, waaronder Bedrijfsmanagement en Elektronica-ICT.
Voor Odisee is het, naast het versterken van de studentenbeleving, belangrijk om een hoge instroom van studenten te verwezenlijken. Dit kan men realiseren door de interesse van toekomstige studenten te wekken via verschillende kanalen. Het aantrekken van nieuwe studenten gebeurt vandaag voornamelijk op een traditionele manier: via infodagen, opendeurdagen en beurzen.
Daarnaast probeert men via de website van Odisee op een aantrekkelijke manier informatie aan te leveren om zo potentiële, nieuwe studenten te overtuigen. Hierbij is het essentieel dat relevante informatie snel vindbaar is door elke doelgroep. Zo zou men de opleidingen van de campussen in Gent en Aalst extra in de kijker kunnen zetten voor het publiek dat surft vanuit Oost-Vlaanderen.
Binnen deze case werd de mogelijkheid onderzocht om bezoekers van de website van Odisee gepersonaliseerde inhoud aan te bieden, met de bedoeling om hen zo snel mogelijk te laten converteren. Op basis van het surf- en klikgedrag kan namelijk een automatische profilering opgesteld worden, waarna groepen van gebruikers afzonderlijk getarget kunnen worden.
Deze use-case werd uitgewerkt in samenwerking met co-hogeschool Odisee en Dropsolid.
www.odisee.be
info@start2aim.be
Belangrijkste learning
- Men hoeft niet steeds te beschikken over een grote hoeveelheid data om aan AI-gedreven personalisatie te doen, zolang er maar voldoende relevante data gecapteerd kunnen worden. Een duidelijke visie en datacultuur over de afdelingen heen blijft wel steeds een belangrijke vereiste.
- Data zijn erg context- en tijdgevoelig, waardoor het moment waarop je de analyse uitvoert, erg impactvol is.
- Er zijn heel wat open-source oplossingen op de markt beschikbaar die ook door KMO’s kunnen toegepast worden, zonder dat dit een grote investering vergt.
- AI-tools hebben een beslissingsondersteunende functie en zijn dus geen doel op zich, maar ze vormen een hulpmiddel om je doelstellingen te behalen.
- Voordat AI succesvol toegepast kan worden, is het belangrijk om de te meten conversiedoelen duidelijk te stellen. Kleine pilots kunnen helpen om stapsgewijs de oplossing uit te rollen.
Personalisatie use-case
De uiteindelijke doelstelling van Odisee is om als onderwijsinstelling de eigen naam te versterken door de studentenbeleving te verhogen en door een grotere studenteninstroom op de verschillende campussen te realiseren.
Door het grote aanbod van opleidingen aan andere hogescholen en de daarbij horende concurrentiestrijd, komt het erop aan om potentiële, nieuwe studenten op een zo gepersonaliseerde manier aan te spreken waardoor deze zich meteen verbonden voelen. Momenteel wordt deze gepersonaliseerde aanpak voornamelijk toegepast in het kader van fysieke contactmomenten, waaronder infodagen en beurzen. Door met studenten in gesprek te gaan en hen te bevragen over hun interesses, kan men kort op de bal spelen.
Odisee wil een stap verder gaan en een gepersonaliseerde aanpak hanteren op de website van de hogeschool door de meest relevante informatie te tonen voor elke doelgroep. Naast potentiële, nieuwe studenten (generatiestudenten en zij-instromers), behoren ook onderzoekers, bedrijven en personeelsleden tot de websitebezoekers. Aangezien er geen gebruikersinformatie aanwezig is van deze bezoekers, is men genoodzaakt beroep te doen op anonieme data met betrekking tot het klik- en surfgedrag, eventueel in combinatie met data rond opgezette campagnes.
Door gebruik te maken van de Dropsolid Digital Experience Cloud, kunnen websitegebruikers door een algoritme op basis van hun gedrag automatisch ingedeeld worden in groepen of segmenten. Een volgende stap omvat de strategische oefening om de gegenereerde segmenten te koppelen aan vooropgestelde persona’s. Voor elk van deze persona’s kan vervolgens op de website gepersonaliseerde inhoud of een aangepaste layout getoond worden.
Strategische aanpak
Samen met de marketingafdeling van Odisee werden de doelstellingen, datacultuur en datamaturiteit in kaart gebracht. Dit vormt een essentiële stap voorafgaand aan de technische uitwerking van de case.
De focus van Odisee ligt enerzijds op het aantrekken van nieuwe studenten en anderzijds op het verbeteren van de beleving van alle belanghebbenden op de Odisee Hogeschool (onder wie studenten, docenten, onderzoekers en ondersteunend personeel). Dit wil men bereiken door aantrekkelijke campagnes te lanceren die gericht zijn op de juiste doelgroep.
Er worden door de marketingafdeling van Odisee drie persona’s vooropgezet:
- Zoekende studenten (zowel generatiestudenten als zij-instromers)
- Personeelsleden van Odisee
- Overige stakeholders (middelbare scholen, jobzoekers, bedrijven)
Een interessante observatie is dat het aandeel van volwassen studenten de laatste jaren significant toeneemt, zelfs in die mate dat er nieuwe personeelsleden werden aangenomen om hierop in te spelen. Het is dus van belang om ook deze groep op een geschikte manier aan te spreken.
Het marketing- en communicatieteam van Odisee staat in voor het uitdenken, lanceren en opvolgen van campagnes (zowel offline als online). Wat betreft studentenwerving wordt vandaag vooral beroep gedaan op historische data rond inschrijvingen.
Verder wordt ook het websiteverkeer van de algemene website (odisee.be) gemonitord door op geregelde tijdstippen de standaard dashboards in Google Analytics te raadplegen.
Aan de slag met de data
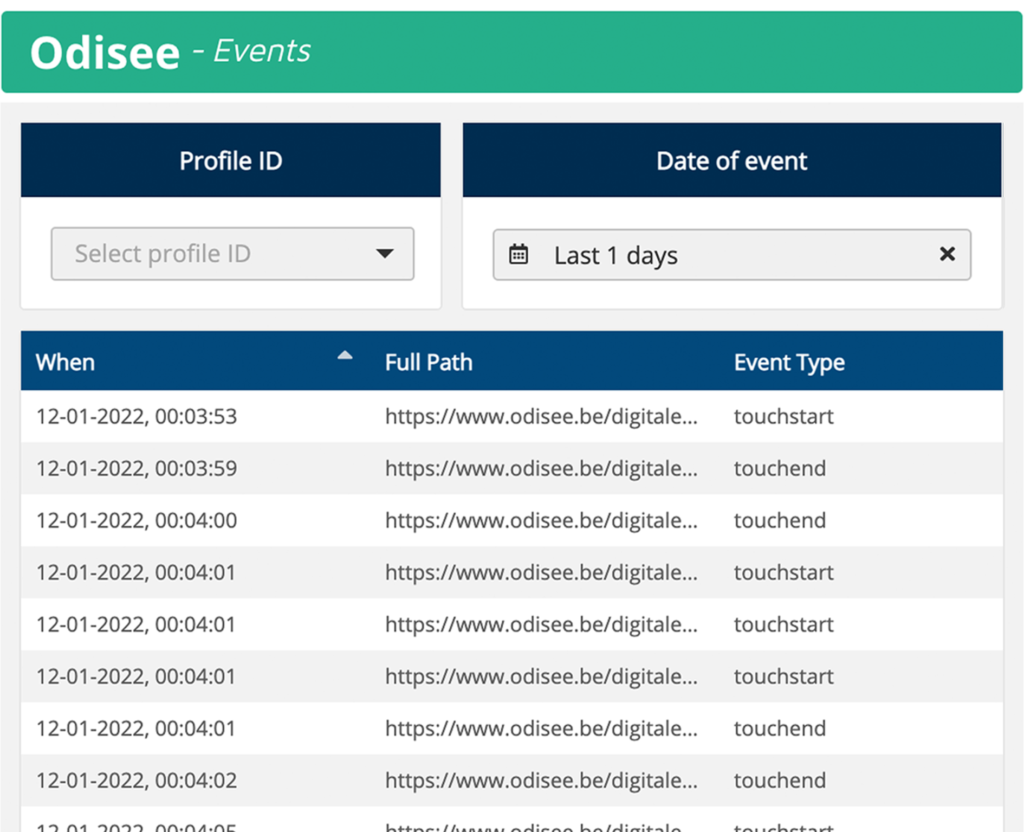
Voor het uitwerken van deze personalisatie use-case is de aanwezigheid van gestructureerde, historische data geen absolute vereiste. Na het activeren van een tracking script op de Odisee-website via Google Tag Manager, kan het gedrag van de bezoekers gecapteerd worden. Deze interactiedata worden verzameld in unieke bezoekersprofielen.
Volgende informatie van een bezoeker kan hierbij onder andere verzameld worden:
- Tijdstip en tijdsduur sessie
- Schermresolutie
- Besturingssysteem
- Taal besturingssysteem
- Toestel (mobiel, computer)
- Locatie op basis van IP-adres
Daarnaast wordt ook het klikgedrag bijgehouden: hyperlinks, afbeeldingen en tekst die de gebruiker geselecteerd of aangeklikt heeft, net als het medium waarlangs zij/hij op de website terechtgekomen is (Google, social media, rechtstreeks).
Een doorgedreven vorm van personalisatie kan men bekomen door deze gedragsinformatie verder aan te vullen met data van marketingcampagnes uit Google Analytics. Op die manier kunnen de resultaten van de personalisatie nauwgezet gemonitord worden. Tijdens de uitvoering van deze case kon enkel gebruik gemaakt worden van interactiedata van websitebezoekers.
Deze data worden aan een AI-algoritme gevoed om automatisch een aantal segmenten te laten opstellen op basis van de meest voorkomende trefwoorden. Deze segmenten kunnen voorgesteld worden als woordwolken en worden door de marketingafdeling afgetoetst en indien mogelijk gekoppeld aan de vooropgestelde persona’s.
Een volgende stap bestaat erin om content op de website er op een andere manier te laten uitzien voor gebruikers van verschillende segmenten (idealiter matchen deze gebruikers met persona’s). Zo zou een inschrijvingsformulier meer in het oog kunnen springen wanneer men detecteert dat er mogelijk een toekomstige student de website bezoekt. Deze functionaliteit is kant-en-klaar beschikbaar bij het bouwen van pagina’s in Drupal. Nieuwe bezoekers kunnen realtime ondergebracht worden in een van deze segmenten op basis van hun gedrag.
In dit kader wordt er gebruik gemaakt van Dropsolid Experience Cloud als DXP. Dit is een geïntegreerd softwareframework dat gebruikt wordt om bezoekers te betrekken en te activeren via verschillende digitale touchpoints. De core componenten van het Dropsolid DXP zijn open source. Zo wordt onderliggend onder meer gebruik gemaakt van het Apache Unomi CDP.
Het tot stand brengen van real-time personalisatie bestaat uit twee stappen:
- Datacaptatie en -segmentatie:
Data werden gecapteerd gedurende een bepaalde periode, waar elke surfsessie als een event gecapteerd werd en gekoppeld werd aan een unieke gebruiker en diens gedrag op de website. Deze data worden in een volgende stap ingezet om automatisch een aantal segmenten te detecteren.

- Personalisatie:
Vertrekkende van de gegenereerde segmenten kan de website interactief gemaakt worden door bepaalde bouwblokken zichtbaar te maken voor gebruikers binnen een bepaald segment. Op die manier krijgt elke doelgroep de meest relevante boodschap te zien, wat leidt tot een subtiele manier van personalisatie.
Binnen deze use-case werd enkel de eerste fase doorlopen, waarbij het surfgedrag van alle websitebezoekers over een vooraf gedefinieerde periode werd verzameld. In het geval van Odisee is vooral de periode net na de zomervakantie interessant. Dit is namelijk de periode wanneer men zich kan inschrijven voor een studierichting. Daarom werden data gemonitord voor de eerste twee weken van september. Vervolgens werden de tien meest voorkomende trefwoorden binnen alle sessies verzameld, waarna door het clusteralgoritme enkele segmenten gegenereerd werden. Ter informatie: het aantal segmenten dat gegenereerd wordt, is een parameter die de gebruiker zelf kan instellen.
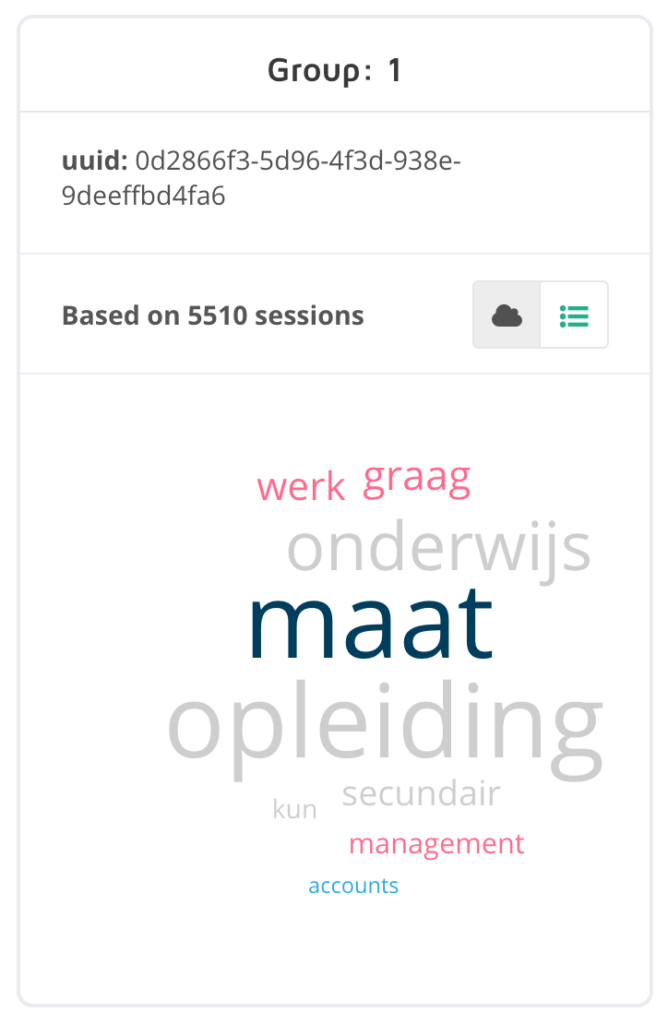
Door het algoritme werden vier segmenten of groepen gegenereerd, die in de vorm van woordwolken gevisualiseerd kunnen worden:
We merken dat Group 0 generatiestudenten voorstelt die op zoek zijn naar een studierichting.
Group 1 is vooral een voorstelling van zij-instromers (de woorden “opleiding”, “werk”, “onderwijs”). Group 3 lijkt een voorstelling te zijn van de Odisee-personeelsleden (de woorden “toegang”, “krijgen”, “personeelsplatform”, “passwoord”, “medewerker”). Group 2 lijkt in dit geval iets minder relevant, doordat de woorden iets minder samenhangend zijn, maar ook omdat deze groep een kleiner aantal sessies vertegenwoordigt in vergelijking met de andere groepen. Deze groep is daarom niet meteen te koppelen aan een van de vooropgestelde persona’s.
Dit resultaat is een eerste stap om gericht en in real-time te communiceren naar verschillende doelgroepen. De koppeling aan marketingacties en het evalueren en bijsturen van de aanpak blijft belangrijk.



Conclusies
Deze use-case toont aan dat het niet steeds nodig is om over een grote hoeveelheid gestructureerde data te beschikken om aan personalisatie te doen. Wanneer men als bedrijf of organisatie beschikt over een website met aanzienlijk wat verkeer, kunnen op een laagdrempelige manier data gecapteerd worden en kan een automatische onderverdeling van de bezoekers gemaakt worden. Bestaande klantdata en data rond marketingcampagnes zouden hierbij ingezet kunnen worden om personalisatie naar een hoger niveau te tillen.
Ondanks de relatief eenvoudige configuratie en de beperkte vereisten rond aanwezige data, mag men niet uit het oog verliezen dat aan een AI-project steeds een strategisch traject voorafgaat waar de doelstellingen en visie worden uitgestippeld. De gebruikte tool is namelijk niet de strategie op zich, maar vormt steeds een hulpmiddel voor de uitwerking van deze strategie.
Personalisatie die een hogere commissie oplevert.
Enkele extra klikken vooraleer je shopt bij je favoriete webshop en als beloning ontvang je een commissie. Klinkt dat niet geweldig? Earnieland is de schakel tussen de online shopper en de webshops en deelt de beloning voor de tussenstop met haar gebruikers. Maar wat als gebruikers steeds vaker rechtstreeks de webshops bezoeken en een tussenstop bij Earnieland vergeten? Hoe detecteer je afhakende gebruikers voor ze helemaal zijn afgehaakt? En hoe reactiveer je slapende gebruikers?
Earnieland is een dochterbedrijf van D’M&S en vormt als het ware een digitale klantenkaart waarmee gebruikers kunnen winkelen bij een 500-tal webshops. Het businessmodel berust op affiliate marketing, wat inhoudt dat aangesloten webshops Earnieland belonen in de vorm van een commissie voor een gerealiseerde aankoop of voor leads die via hen gegenereerd werden. Een deel van deze commissie stort Earnieland vervolgens ‘als beloning’ door naar haar gebruikers. De webshop in kwestie kan op haar beurt genieten van een verhoogde klanteninstroom door Earnieland-leden.
Het is voor Earnieland dan ook essentieel om de klantenbetrokkenheid hoog te houden. Dit wil men doen door inactieve klantprofielen te detecteren en deze te reactiveren door hen gepersonaliseerde cashbacks, deals en vouchers aan te bieden. Deze kunnen aangekocht worden door EarnieCoins in te ruilen. Deze EarnieCoins zijn het resultaat van het Earnieland loyalty programma.
Deze use-case werd uitgewerkt samen met Earnieland en het Start2AIM-team.

www.earnieland.be
andreas@earnieland.com
Belangrijkste learning
Door de aanwezigheid van een grote hoeveelheid gestructureerde data kon al snel een eerste resultaat behaald worden. De verworven inzichten tonen heel wat mogelijkheden voor potentiële acties en campagnes.
Naast historische data zijn ook interactiedata en data rond marketingcampagnes erg belangrijk. Hiervoor is een samenwerking en communicatie tussen verschillende departementen en expertiseprofielen cruciaal.
Een AI-algoritme hoeft niet alles van A tot Z op te lossen. Je kan AI vaak in een latere fase in het project introduceren en toepassen op het resultaat van eerdere analyses. In deze case vertaalt dit zich als het inzetten van een AI-clusteralgoritme op het resultaat van een eerder uitgevoerde RFM-analyse.
Personalisatie use-case
Het Earnieland platform is gebaseerd op het affiliate marketingmodel: consumenten die winkelen in de webshops van de aangesloten partners (zoals Torfs, JBC, Dreamland) worden in cash beloond. Earnieland wil zich profileren binnen deze markt door hun gebruikers te leren kennen en hen op die manier een aangename shopervaring te bieden. Wie een online aankoop verricht bij een webshop die aangesloten is bij Earnieland en eerst via Earnieland surft (of de browserextensie heeft geïnstalleerd), wordt daarvoor beloond.
Sinds de oprichting van Earnieland in 2004 heeft men heel wat nieuwe leden kunnen aantrekken. Het klantenbestand is heel divers, met zowel mannelijke als vrouwelijke, en jonge als iets oudere gebruikers. Men kan verschillende klantentypes identificeren op vlak van aantal aankopen en aankoopbedrag (en de daarbij horende commissie). Aangezien de leden de drijvende kracht zijn van Earnieland, is het noodzakelijk om hun betrokkenheid zo hoog mogelijk te houden. Meer specifiek wil men de klanten detecteren met een hoge Customer Lifetime Value (CLV), maar die recent niet meer via Earnieland besteld hebben. Door het implementeren en inzetten van een Recommender System, kan men deze gebruikers een persoonlijk aanbod doen onder de vorm van webshops die passen bij hun aankoopgedrag.
Strategische aanpak
De marketingstrategie is gebaseerd op sharing revenue of het delen van inkomsten met gebruikers, en is vooral gericht op de activering en retentie van gebruikers. Het zijn namelijk de gebruikers die de groei van het platform en de bijhorende omzetstijging mogelijk maken.
Momenteel bevindt Earnieland zich in een oriënterende fase en is het opzetten van AI-oplossingen de taak van enkele experten van D’M&S.Deze experten focussen zich op de strategische en technische uitwerking. AI wordt niet als een oplossing beschouwd, maar als een tool om business value te creëren: het resultaat van een AI-algoritme dient omgezet te worden naar concrete communicatieacties.
Er wordt veel belang gehecht aan de data van klanten en de privacy ervan. Daarom worden enkel First Party Data gebruikt door middel van First Party Cookies. Dit betekent dat de gebruiker uitdrukkelijk toestemming moet geven voor het gebruik van haar/zijn data. Deze data staan gebruikers toe om hun eigen digitale ervaring op Earnieland te verbeteren.
Datakwaliteit is en blijft een uitdaging. Alle data worden opgeslagen in een relationele MySQL-database op Amazon Web Services (RDS AWS), waar de data ondergebracht worden in een 125-tal verschillende tabellen. Earnieland rekent op de ontwikkelaar van het platform voor het structureren en beheren van deze data.
Datavisualisatie gebeurt in het Earniebase-platform. Dit is een custom back-office systeem dat de data van Earnieland visualiseert aan de hand van verschillende dashboards. Dit systeem staat toe om de data op een overzichtelijke manier te monitoren, maar ook om de nodige drill-downs te doen wanneer nodig. Hiernaast worden PowerBI-dashboards gebruikt om inzichten in de data te verwerven. Om de data voor te bereiden tot AI-analyses, worden regelmatig testen uitgevoerd met SQL-queries.
Aan de slag met de data
De uitwerking van deze use-case is tweeledig: eerst worden de klanten geïdentificeerd die men wenst te reactiveren door het uitvoeren van een RFM-analyse. Vervolgens wordt een Recommender System ingezet om gepersonaliseerde aanbiedingen te versturen naar inactieve klanten.
Identificatie van klanten om te reactiveren
Om inzicht te verwerven in het klantenbestand, wordt een RFM-analyse uitgevoerd, die elke klant een waarde toewijst voor R (recency – wanneer was de laatste aankoop), F (frequency – hoe frequent heeft men besteld) en M (monetary value – voor welk aankoopbedrag heeft men besteld). Op basis van deze RFM-toewijzing kan men elke klant onderverdelen in een klantensegment, waarbij de grootte van elke rechthoek in onderstaande figuur een maat is voor het aantal klanten die behoren tot dat segment.
Vanuit een marketingperspectief kan men vervolgens focussen op de klantensegmenten die voor het bedrijf belangrijk zijn. In deze use-case richten we ons op het reactiveren van gebruikers uit het segment Can’t Loose en At Risk.
- At Risk (12,3%): Deze klanten hebben dikwijls besteld en voor een aanzienlijk bedrag, maar hun laatste aankoop is reeds enige tijd geleden.
- Can’t Lose (0,6%): Dit omvat de gebruikers die erg frequent bestelden, maar dit onlangs niet meer gedaan hebben. In vergelijking met de At Risk groep, hebben deze klanten iets frequenter besteld en voor een hoger bedrag.
Klanten uit beide klantensegmenten wil men reactiveren door hen op een subtiele manier aan te spreken. Zo kan je hen bijvoorbeeld via e-mail of de website van Earnieland gepersonaliseerde aanbiedingen tonen van webshops die binnen hun interessegebied vallen. Een Recommender System kan ons helpen om op basis van de data relevante aanbiedingen voor te stellen.
Aanbieden van gepersonaliseerde cashbacks
Van elke klant is onder andere volgende informatie per aankoop beschikbaar:
- Bezochte webshop
- Aankoopbedrag
- Tijdstip
- Commissie gebruiker
- Commissie Earnieland
Voor elke klant die zich binnen het At Risk of Can’t Lose segment bevindt, wordt gekeken naar de webshop waar men het laatst via Earnieland een aankoop heeft verricht. Op basis daarvan wordt een lijst van webshops voorgesteld waar klanten met een gelijkaardig kooppatroon ook gekocht hebben.
Om dit te realiseren, wordt gebruik gemaakt van collaborative filtering. Collaborative filtering is een techniek om artikelen te vinden waaraan een gebruiker de voorkeur zou kunnen geven op basis van informatie die is verzameld bij andere gebruikers met een soortgelijke voorkeur. Het berust op het idee dat als persoon X en persoon Y een bepaalde reactie hebben op bepaalde artikelen, zij ook dezelfde mening hebben over andere artikelen. Binnen collaborative filtering wordt verder nog een onderscheid gemaakt tussen user-based en item-based filtering.
In deze use-case wordt een item-based collaborative filtering model (Carleton College, n.d.) opgesteld. Deze vorm van Recommender System werkt als volgt:
Gebruiker 1 koopt druiven, aardbeien, meloenen en sinaasappels aan. Wanneer gebruiker 2 aardbeien en meloenen aankoopt, gaat men ervan uit dat we deze persoon ook druiven en sinaasappels mogen aanraden.
In de huidige use-case worden items gemodelleerd als de webshops waar iemand heeft aangekocht. Men zal dus webshops (of de aanbiedingen binnen deze shops) aanraden aan gebruikers met een gelijkaardig aankooppatroon.
De volgende tabel toont de voorspellingen voor een volgende interessante webshop voor vijf gebruikers die men wenst te reactiveren. Hier is gekozen om de twee meest waarschijnlijke opties terug te geven. We kunnen opmerken dat de aanbevolen shops gelijkaardig zijn aan diegene waar men het laatst aankocht, ook al werden de eigenschappen van een shop zelf niet in rekening gebracht, enkel het koopgedrag van alle gebruikers.
user_id | Shop_Name | Shop Recommendation | |
296835 | 14065 | AliExpress | [Bol.com, MediaMarkt] |
37820 | 3667 | Hotels.com | [Booking.com, Expedia] |
182954 | 1218 | Bol.com | [Coolblue, AliExpress] |
1617 | 1894 | Coolblue | [Bol.com, MediaMarkt] |
138098 | 22441 | Zeb | [Torfs, JBC] |
In de uitwerking van de case werden shops aanbevolen op basis van het koopgedrag van andere gebruikers. Een uitbreiding bestaat erin om ook gebruikersdata (waaronder leeftijd, geslacht, woonplaats) en interactiedata (klikgedrag) op de website van Earnieland op te nemen bij het genereren van deze aanbevelingen. Op die manier kunnen meer gerichte voorspellingen gemaakt worden.
Een concrete marketingactie die men aan dit resultaat kan koppelen, is een mailingcampagne gericht op inactieve klanten (At Risk en Can’t Lose segment). Door een automatische selectie te maken van lopende cashback-promoties bij aanbevolen webshops, kan men op een subtiele manier klanten reactiveren met een gepersonaliseerd aanbod.
Conclusies
Door data gestructureerd en over een langere periode op te slaan, kan men op een kleinschalige en laagdrempelige manier de mogelijkheden van AI en personalisatie aantonen. Door de resultaten vervolgens te evalueren, kan men bijsturen en stapsgewijs de use-case verder uitbreiden. Men hoeft AI ook niet steeds te implementeren als belangrijkste component binnen een project: het kan eveneens toegepast worden op het resultaat van een eerdere analyse. In deze case vertaalt dit zich als het inzetten van een AI-clusteralgoritme op een eerder uitgevoerde RFM-analyse.
Ook in de omgekeerde richting, gericht naar de aangesloten webshops, is personalisatie mogelijk. Inzichten met betrekking tot het shopgedrag kunnen helpen om speciale campagnes te voeren, zoals bv. korting enkel voor leden van Earnieland, extra commissies gedurende enkele dagen, enzoverder.
In deze concrete case zouden de bestaande aankoopdata verder aangevuld kunnen worden met profieldata, data rond marketingcampagnes en het klikgedrag op de website. Op die manier kan men gebruikers nog persoonlijker en gerichter aanspreken.
Afhakende klanten overtuigen met een gepersonaliseerd aanbod.
De energiemarkt is één van de meest competitieve markten in België, waar overstappen naar een nieuwe leverancier zeer makkelijk en snel geregeld kan worden. Maar hoe detecteer je klanten die willen vertrekken en overtuig je ze om toch te blijven?
Deze leverancier is actief in de verkoop en levering van gas en elektriciteit, zowel voor particulieren als voor professionele klanten. Ondanks het groeiend belang van het webkanaal voor deze leverancier, blijft het callcenter nog steeds het belangrijkste middel voor zowel de verkoop als het aanbieden van dienstverlening.
De energiemarkt is een van de meest competitieve markten die we heden ten dage kennen. Dit is hoofdzakelijk te wijten aan het feit dat het vandaag erg eenvoudig is voor de eindklant om van leverancier te veranderen. Om die reden is het essentieel om de klanttevredenheid op elk moment hoog te houden.
Een nieuwe klant binnenhalen is doorgaans vijf maal duurder dan het behouden van een klant. Het opzet is dan ook om klanten die dreigen af te haken, proactief op te sporen middels het gebruik van data. Om vervolgens ook effectief resultaat te boeken, wil men deze klanten een gepersonaliseerd energievoorstel aanbieden zonder margeverlies te moeten lijden. Dit vereist eveneens een datagedreven aanpak.
Deze use-case werd aangebracht door CNEXT.

www.cnext.eu
roelvdb@cnext.eu
Belangrijkste learning
Het betrekken van iedereen binnen het bedrijf leidt tot een snellere toepassing van de oplossing in de dagdagelijkse praktijk (anders is de kans groot dat het een leuke oefening betrof die uiteindelijk niets oplevert). Daarnaast zijn de ervaringen die de medewerkers van het bedrijf delen van goudwaarde om te bepalen welke data het meest bruikbaar zijn bij het opstellen van AI-modellen.
Om een positieve impact te hebben op het bedrijfsresultaat, volstaat het niet om louter te verhinderen dat klanten afhaken: dit moet ook op een manier gebeuren waarbij de winstmarge behouden blijft. Het kunnen optimaliseren van verschillende objectieven tegelijk, zoals klantretentie en winstmarge, was in deze use-case dan ook cruciaal.
AI is erg geschikt voor het verwerken van grote hoeveelheden data. Daar tegenover staat dat de mens in staat is om goede inschattingen te maken op basis van relatief weinig data. De eindbeslissing zal steeds door een mens gemaakt worden. Het resultaat van een project kan sterk geoptimaliseerd worden door de juiste balans te vinden tussen de mens enerzijds, en het AI-algoritme anderzijds.
Personalisatie use-case
Het is voor de consument erg eenvoudig om de overstap te maken naar een andere elektriciteitsleverancier. De belangrijkste doelstelling is dan ook om de klantenloyaliteit en de daaruit vloeiende klantretentie te verhogen terwijl de winstmarge voor de energieleverancier absoluut niet mag dalen.
Hierbij zijn drie zaken belangrijk:
- Het is noodzakelijk om over een goedwerkend algoritme te beschikken dat de kans voorspelt of een klant al dan niet afhaakt. Dit wordt ook wel churn prediction genoemd.
- De impact van het vertrek van een specifieke klant op het bedrijf moet duidelijk zijn, net als wat een klant tijdens haar/zijn levenscyclus zal opbrengen ten voordele van het bedrijf. Een goede voorspelling van de Customer Lifetime Value (CLV) is dan ook essentieel.
- Het is belangrijk om te handelen op basis van het resultaat en gepast te reageren. De callcenteragent krijgt een lijst met gepersonaliseerde aanbiedingen van energiecontracten per klant die dreigt af te haken. Aangevuld met een eigen inschatting van de situatie, kiest de agent vervolgens het juiste aanbod uit deze aanbevelingen.
Er zijn verschillende databronnen beschikbaar om aan het algoritme te voeden. De belangrijkste bron omvat de ordergegevens. Deze data zijn van hoge kwaliteit doordat deze door het systeem automatisch en gestructureerd worden opgeslagen. Deze gegevens worden nog verder verrijkt met bepaalde data, zoals eventuele klachten en het betalingsgedrag.
Strategische aanpak
De belangrijkste algemene doelstelling is het verhogen van de klantretentie waarbij de marge per contract behouden blijft. Hierbij werd er steeds gekeken naar hoe data-gedreven inzichten en voorspellingen kunnen helpen om de effectiviteit te verhogen.
Er is alvast een sterke datacultuur aanwezig bij de leverancier waardoor er voldoende en kwalitatieve data aanwezig zijn voor data-analyse. In totaal waren er data van meer dan 400.000 klanten beschikbaar, wat overeenkomt met miljoenen orderlijnen en interacties. Hierdoor is er een draagvlak om dergelijke projecten aan te vangen en tot een goed einde te brengen.
Er zijn verschillende applicaties aanwezig die data op een gestructureerde manier verzamelen en ontsluiten doorheen de tijd en op klantniveau.
De belangrijkste systemen zijn:
- een ERP-systeem voor orderdata en betalingsgedrag;
- een ticketsysteem om klachten te behandelen;
- een CMS-applicatie om verkoopsgegevens te registreren;
- een field service applicatie om de gepresteerde uren van de callcenteragent per klant bij te houden.
Er kan niet rechtstreeks overgegaan worden van deze data naar het uitvoeren van een data-analyse. De data moeten eerst op een goede manier gelinkt worden, waarna outliers dienen verwijderd te worden en de data genormaliseerd moeten worden. De verschillende data flows van en naar de verschillende systemen worden ook geautomatiseerd en continu gemonitord, waardoor de stap van pilootproject naar het productieplatform op een vlotte manier gezet kan worden.
Aan de slag met de data
Er werd gebruikgemaakt van meerdere machine learning modellen voor het voorspellen van:
- de kans dat een klant zal afhaken;
- de Customer Lifetime Value (CLV);
- de kans dat een bepaald voorstel aanvaard wordt door de klant.
Deze modellen worden in functie van de vooropgestelde bedrijfsobjectieven (klantretentie verhogen en winstmarge behouden) gecombineerd en geoptimaliseerd opdat het beste resultaat behaald kan worden.
De data zijn verspreid over verschillende systemen en werden eerst samengevoegd opdat een eenzijdig beeld per klant gemaakt kon worden. Met domeinspecialisten binnen het bedrijf werd er bekeken welke factoren kunnen leiden of bijdragen tot het vertrekken van klanten naar de concurrentie. Dataspecialisten bekeken vervolgens hoe deze gegevens of features uit de bestaande data geëxtraheerd konden worden.
Volgende data zijn in gestructureerde vorm aanwezig:
- Afgesloten energiecontracten
- Klantinformatie (vereiste data om facturen op te maken)
- Het aantal en type geregistreerde contactmomenten (klacht, vraag, aankoop)
- Verbruik
- Eventuele klachten
- Betaalgedrag (op tijd, te laat, veel te laat)
Voor de uitwerking van deze use-case werd gebruik gemaakt van het Cnext-platform. Het trainen van ML-modellen kan hierbij zowel in de cloud als on-premise gebeuren. Het resultaat is een top drie van gepersonaliseerde aanbiedingen, die worden aangeboden in de callcenter applicatie samen met de voorspellingen rond het klantgedrag. Hierbij was het eveneens van belang dat deze inzichten zonder veel tijdverlies geïnterpreteerd konden worden door de callcenteragent. De oplossing lag in een eenvoudige, maar intuïtieve visualisatie (Figuur 1).
Door een accurate voorspelling van de CLV en mogelijke afhakers, kan op een precieze manier bepaald worden wie een speciale behandeling dient te ontvangen en wat deze moet inhouden om de klantretentie te verhogen.
Conclusies en uitdagingen voor de toekomst
De resultaten afkomstig van het AI-algoritme, gecombineerd met de expertise van de callcenteragent lieten toe om geoptimaliseerde aanbevelingen te doen. Hierdoor stegen zowel de klantretentie als de totale winstmarge.
In de toekomst zal door het gebruik van digitale meters nog meer data gecapteerd kunnen worden op een gestructureerde manier, waardoor op klantniveau nog meer accurate inzichten kunnen gegenereerd worden.